常用数学記号
AI論文やチュートリアルを読み解く最初のハードルは、たいてい数学そのものではなく、ページ中に並ぶ数学記号である。
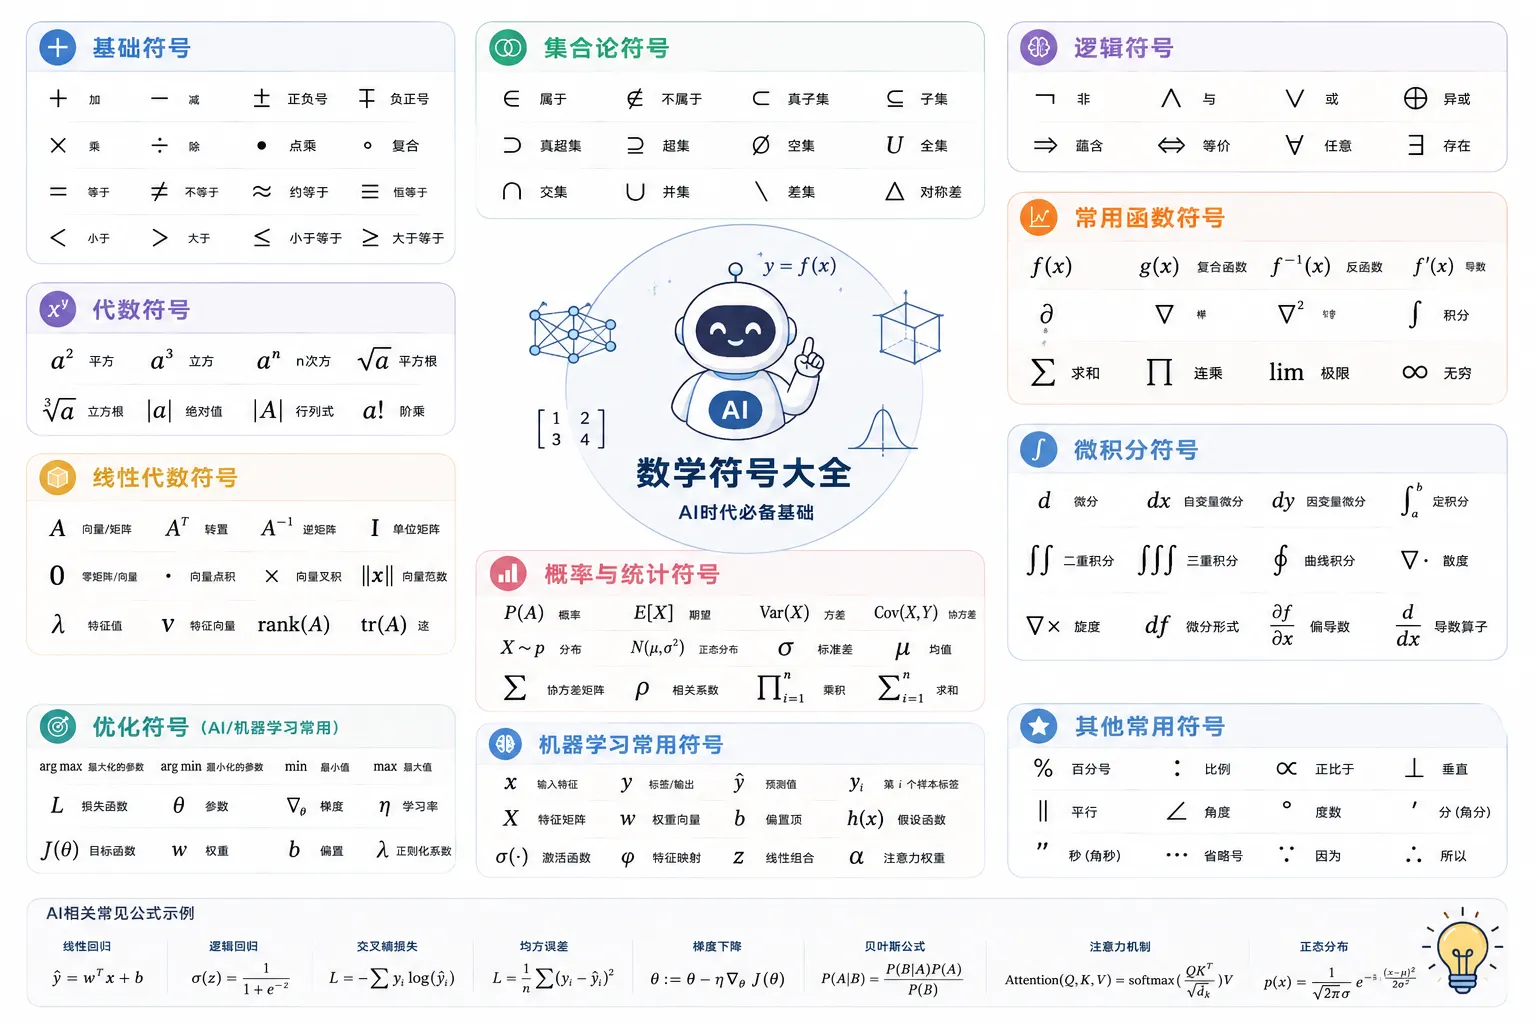
この章では、AI学習で最もよく使う記号を表にまとめた。ざっと目を通してもよいし、後で必要になったときに調べに来てもよい:
-
順番に通読する:各記号に「いつ使うか」の説明を付けているので、ざっと目を通して全体像をつかもう。
-
その都度調べて使う:論文やチュートリアルを読んでいて、ある記号で詰まったら、この表を調べに戻ろう。
ほとんどの記号には実行可能なPythonサンプルが付いている。自分で手を動かして一度計算してみる方が、10回見るより効果的だ。
数と基本演算
これらの記号は小学校の算数から使うもので、すべての公式の土台である。
| 記号 | 意味 | 例 |
|---|---|---|
| 加法、減法、乗法、除法 | ||
| 正負の符号。2つの可能な値を表す | ||
| 等しくない | ||
| 小なり、大なり、以下、以上 | ||
| ほぼ等しい | ||
| 絶対値。負の符号を取り除く | ||
| 平方根 | ||
| n乗根 | ||
| 平方、n乗 | ||
| 逆数(負の指数) | ||
| 階乗。1からnまで掛け合わせる | ||
| 無限大 |
論文では乗算記号は通常省略されるか、小さな点で書かれる:wとxを掛けることを表し、2つの書き方は完全に同じ意味である。
変数と文字の約束事
数学では文字は適当に選ばれているわけではなく、文字ごとに既定の役割がある。
| 文字 | 既定の役割 | AIの文脈での典型的な意味 |
|---|---|---|
| 定数 | 固定されて変化しない係数 | |
| 変数 | xは入力特徴量、yは出力ラベル | |
| 重みとバイアス | ニューラルネットワークが学習するパラメータ | |
| パラメータ集合 | モデル全体のパラメータの総称。thetaと読む | |
| 数(個数) | サンプル数、特徴量の次元数 | |
| 円周率 | ||
| 自然対数の底(ネイピア数) |
xとXを同時に使う場合は、区別に注意が必要:小文字は通常、1つの数(スカラー)を表し、大文字は通常、行列を表す、これについては小文字の節で詳しく述べる。
見かけても焦らないで。これは単に「パラメータ」の慣用的な記号であり、本質的な違いはない。論文の著者がどちらを選ぶかは純粋に好みの問題だ。
指数と対数
AIで最も登場頻度の高い関数のペアである。
sigmoidとsoftmaxに登場し、数値を「拡大または圧縮」する役割を担う;交差エントロピー損失に登場し、「掛け算を足し算にする」役割を担う。
| 記号 | 意味 | 例 |
|---|---|---|
| aのn乗 | ||
| 任意の非ゼロ数の0乗 | ||
| eを底とする指数関数 | ||
| aを底とするxの対数 | ||
| 自然対数(eを底とする) | ||
| 論文では通常、暗黙にこの自然対数を指す |
4つの演算規則はしっかり使いこなせるようにしておく必要がある。損失関数の導出で繰り返し使われる:
底の変換公式を使えば、任意の底の対数を自然対数に変換できる。プログラミングでもよく使われる:
例
# Pythonのmath.log(x, base)は内部でこのようにしている
import math
x = 100
base = 2
# 直接呼び出す
print(math.log(x, base))
# 底の変換公式を手書き:log_2(100) = ln(100) / ln(2)
print(math.log(x) / math.log(base))
上記のコードを実行すると出力結果は次のようになる:
6.643856189774725
6.643856189774725
なぜ小さな定数 ε を加えるのか:対数の真数は0より大きくなければならないが、学習初期のモデルが確率0を出力することがある。そのとき負の無限大になり、学習が崩壊する。
そのため実装では通常、次のように書く:、ただしは非常に小さな正の数、例えば0.0000001である。
関数関連の記号
関数とは「入力から出力への対応規則」である。ニューラルネットワークは本質的に、多くの層の関数を合成したものである。
| 記号 | 意味 | 例 / 説明 |
|---|---|---|
| 関数。xをfで写した結果 | ||
| fは集合Aの要素を集合Bに写す | 関数の「型シグネチャ」を表す | |
| 逆関数。fの操作を取り消す | ||
| 合成関数。g(x)を先に計算してからfに代入する | ||
| xの変化量 | ||
| yの予測値(y-hatと読む) | 真のラベルyと区別する | |
| sigmoid活性化関数 |
機械学習では(y-hatと読む)は専らモデルの予測値を指し、は真のラベルを指す。両者の差が予測誤差である。
合成関数はニューラルネットワークを理解するための鍵である:2層ネットワークは本質的にであり、逆伝播で層ごとに勾配を計算する際に頼るのは、まさに合成関数の微分における連鎖律である。
例
# g(x) = x + 1、f(x) = x^2 とする
def g(x):
return x + 1 # 内側の関数
def f(x):
return x ** 2 # 外側の関数
# 合成:g(x)を先に計算し、その結果をfに代入する
print(f(g(3))) # g(3)=4, f(4)=16
print(f(g(3)) == (3 + 1) ** 2)
上記のコードを実行すると出力結果は次のようになる:
16
True
総和と総乗
AIの公式で最も登場頻度の高い記号であり、他に並ぶものはない。
その意味は、下付き文字iを下限から上限まで動かし、各項をすべて足し合わせるということである。
「iは1からnまで、xの下付きiについて総和を取る」と読む。総和式を読むときは3つのステップに分ける:
| ステップ | 何を見るか | この例では |
|---|---|---|
| 1 | 総和の変数はどれか(下付き文字) | i |
| 2 | 総和の範囲(下限から上限まで) | 1からnまで |
| 3 | 各項がどのような形か |
総乗の記号構造は同じで、「足す」を「掛ける」に置き換えただけである:
最も一般的な2つのAI公式はどちらも総和に基づいている:
平均二乗誤差損失:
ニューロンの重み付き総和:
例
w = [0.5, -1.0, 2.0] # 重み。公式のw_iに対応
x = [2.0, 3.0, 1.0] # 入力。公式のx_iに対応
b = 0.1 # バイアス
# sum_{i=1}^{3} w_i * x_i は次の行に相当する
z = sum(wi * xi for wi, xi in zip(w, x)) + b
print(z)
# 展開して確認:0.5*2 + (-1.0)*3 + 2.0*1 + 0.1
print(0.5*2 + (-1.0)*3 + 2.0*1 + 0.1)
上記のコードを実行すると出力結果は次のようになる:
0.1
0.1
集合と論理
集合記号は「データがどの集合に属するか」を表し、論理記号は「条件をどのように組み合わせるか」を表す。確率と機械学習の理論で多用される。
| 記号 | 意味 | 例 |
|---|---|---|
| 属する | ||
| 属さない | ||
| 部分集合 | ||
| 和集合 | ||
| 共通部分(積集合) | ||
| 空集合(要素を一切含まない) | ||
| 実数集合 | ||
| 任意の、すべての(全称量化子) | ||
| 存在する(存在量化子) | ||
| 論理否定 | ||
| 論理積、論理和 | ||
| 含意(ならば) | ||
| 同値(必要十分条件) |
これらの記号は論文の定理や仮定の部分で最もよく現れる。例えば「「任意の0より大きいepsilonに対して、あるNが存在する」と読む。
上付き・下付き文字と値の範囲
この節では、よくある2つの疑問を解決する:下付き文字は一体何を意味するのか、そして区間記号はどう読むのか。
下付き文字:同じ種類の変数に番号を付ける
訓練データには多くのサンプルがあり、すべてxで表すと混乱する。そこで下付き文字で区別する:。
添え字が2つあるとき、例えばは通常「i 行 j 列」を意味し、これはまさに行列の要素です。
ベクトルは(太字)で表記され、その成分はです。行列の形状は「行数 × 列数」で表し、。
区間と値の範囲
丸括弧は「端点を含まない」、角括弧は「端点を含む」ことを表します。
| 記号 | 読み方 | 意味 |
|---|---|---|
| 開区間 | a と b の間のすべての数。両端を含まない | |
| 閉区間 | a と b の間のすべての数。両端を含む | |
| 半開区間 | b を含み a を含まない | |
| x は閉区間 | x は 0 から 1 までの値を取り、端点でもよい |
sigmoid 関数の値域はです。この開区間は、出力が常に 0 より厳密に大きく 1 より小さいことを意味し、これこそが「確率」として使える数学的な理由です。
ギリシャ文字表
論文に並ぶギリシャ文字は飾りではありません。それぞれに既定の意味があり、すべて覚えておくと論文がだいぶ読みやすくなります。
| 大文字 | 小文字 | 名称 | AI での一般的な意味 |
|---|---|---|---|
| alpha | 学習率 | ||
| beta | モーメンタム係数、Adam の二次モーメント減衰率 | ||
| gamma | 割引率(強化学習) | ||
| delta | 変化量、増分 | ||
| epsilon | 極小の正数、探索確率 | ||
| theta | モデルのパラメータ | ||
| lambda | 正則化係数 | ||
| pi | 方策(強化学習)、円周率 | ||
| sigma | 総和 / sigmoid 関数、標準偏差 | ||
| phi | 特徴マッピング関数 | ||
| omega | モデルの重み(一部の論文) |
同じ記号でも分野によって意味が異なります:活性化関数の文脈では sigmoid、統計の文脈では標準偏差、総和の式では大文字が総和演算子です。意味を見るときはまず文脈を見る。これが論文を読む上で最も重要な習慣です。
確率と統計
機械学習の中核言語です。分類モデルが出力する「信頼度」、損失関数の導出、ベイズ手法は、すべてこれらの記号の上に成り立っています。
| 記号 | 意味 | 例 / 説明 |
|---|---|---|
| 事象 A が起こる確率 | ||
| 条件付き確率:B が起こったときの A の確率 | 縦棒は「……という条件の下で」と読みます | |
| 同時確率:A と B が同時に起こる確率 | ||
| ベイズの公式 | すべてのベイズ手法の根基 | |
| 期待値(平均) | ||
| 分散(ばらつきの程度) | ||
| 平均 | データ分布の中心 | |
| 分散(シグマの2乗) | ||
| ……の分布に従う | ||
| 正規分布(ガウス分布) | 括弧の中は平均と分散 | |
| 情報エントロピー |
交差エントロピー損失はこれらの記号の集大成であり、総和・条件付き確率・対数を組み合わせたものです:
記号を1つずつ分解すると:は i 番目のサンプルの正解ラベルで、はモデルの予測確率です。確率の掛け算を足し算に変換し、負号によって「損失が小さいほど良い」としています。
は「Normal」の筆記体表記で、正規分布を指します。文字 N ではありません。筆記体の記号、は、分布・損失関数・データセットといった「集合的な」対象を表すのによく使われます。
線形代数
ニューラルネットワークの基盤となる構造です。ディープラーニングフレームワークの毎回の行列演算は、これらの記号を使っています。
| 記号 | 意味 | 例 / 説明 |
|---|---|---|
| ベクトル(太字小文字) | ||
| 行列(太字大文字) | m 行 n 列の数の表 | |
| 転置:行と列を入れ替える | 行ベクトルが列ベクトルになる | |
| 行列の掛け算 | 要素ごとの掛け算ではない | |
| 要素ごとの積(アダマール積) | 同じ形状の行列の対応する位置どうしを掛ける | |
| ノルム(ベクトルの「長さ」) | ||
| L1 ノルム:絶対値の和 | L1 正則化の基礎 | |
| 逆行列 | ||
| 単位行列 | 対角成分が 1、それ以外が 0 | |
| ドット積(内積) |
ドット積は attention 機構の骨格です。transformer の各層はクエリベクトルとキーベクトルのドット積を計算し、それらの「類似度」を測っています。
例
# x · y = sum(x_i * y_i),||x||_2 = sqrt(sum(x_i^2))
import math
x = [1.0, 2.0, 3.0]
y = [4.0, 0.0, -1.0]
# ドット積 x · y
dot = sum(xi * yi for xi, yi in zip(x, y))
print(dot)
# L2ノルム ||x||_2
norm2 = math.sqrt(sum(xi ** 2 for xi in x))
print(norm2)
# 展開して検証
print(1.0*4.0 + 2.0*0.0 + 3.0*(-1.0))
print(math.sqrt(1 + 4 + 9))
上記のコードを実行すると、出力は次のようになります:
1.0
3.7416573867739413
1.0
3.7416573867739413
微分積分
トレーニングの本質は「勾配の反対方向にパラメータを調整する」ことなので、論文の最適化の章はこれらの記号なしには成り立ちません。
今すぐ計算できなくても構いません。それぞれの記号を読み解ければ十分です。
| 記号 | 意味 | 例 / 説明 |
|---|---|---|
| 導関数:x に対する y の変化率 | ||
| 導関数のもう一つの表記 | ||
| 偏微分:x だけが変化するときの f の変化率 | 多変数関数では | |
| 勾配:すべての偏微分からなるベクトル | ||
| 積分。微分の逆演算 | ||
| 極限:x が a に近づくときの値 |
ディープラーニングで最も重要な公式は、上の表の2行だけを使っています。勾配降下法のパラメータ更新規則です:
記号を1つずつ分解すると:はパラメータで、は「右辺の値で左辺を更新する」ことを表し、は学習率で、は損失関数 J のパラメータ θ に対する勾配です。
一言で言うと:新しいパラメータ = 古いパラメータ − 学習率 × 勾配、すなわち損失を最も速く減らす方向へ小さく一歩踏み出すことです。
これは「ナブラ」または「勾配オペレータ」と読みます。数値ではなく、「後ろのすべての変数に対して偏微分を取る」という操作命令であり、プログラミングにおける高階関数によく似ています。
最適化とその他の頻出記号
最後のこの節は、論文に断片的に現れるものの非常に重要な記号です。
| 記号 | 意味 | 例 / 説明 |
|---|---|---|
| f を最大にする x | 返すのは x であり、最大値そのものではない | |
| f を最小にする x | トレーニングとはすなわち | |
| f の最小値を求めること | 数値そのものを返す | |
| softmax 関数 | ||
| 関数の合成 | ||
| 次のように定義する | 左辺を右辺の値として定義する | |
| に比例する | ||
| ReLU 活性化関数 | ||
| ランダウの O 記号:増加のオーダー | 定数を無視し、規模だけを見る |
分類モデルが予測するときに行っているのはまさにです。確率が最大のクラスを取り出し、argmax が返すのはクラスの番号であって、確率の数値ではありません。
と非常に混同しやすいポイント:は「最大値はいくつか」に答え、は「どの x で最大値を取るか」に答えます。分類タスクが関心を持つのは後者です。
学習のアドバイス
記号表を丸暗記する必要はありません。記憶よりも方法のほうが効果的です。
第一に、記号を1つずつ分解する習慣をつけましょう。公式に出合ったら、各記号が演算子・変数・関数のどれかをまず問い、次にその記号が現在の文脈で何を表すかを問います。分解し終えると、たいてい謎ではなくなります。
第二に、次の3つを優先的に徹底的に理解しましょう:総和、指数と対数、添え字の記法。これらは線形代数と微分積分の公式を読み解くための前提条件であり、本稿ではそれぞれ専用の節を設けています。
第三に、知らない記号に出合ったら「記号名 + 数学的な意味」を直接検索するのが、教科書に粘り強く取り組むより速いです。
その他の拡張記号は地図であり、地形そのものではありません。本当の理解は、それらを使って具体的な例を計算した経験から得られます。本稿の Python の例はすべて、実際に手を動かして実行する価値があります。