Union-Find 経路圧縮
Union-Find の find 関数では、ある点のルートノードをより速く見つけるために経路圧縮を行うことができます。集合ツリーでは、ルートノードの下に多くのノードがぶら下がっています。そこで、find の過程で、ボトムアップ(下から上へ)に、もし現在アクセスしているノードがルートノードでない場合、そのノードをできるだけ上に移動させて、木の階層を減らすことができます。このプロセスを経路圧縮と呼びます。
下の図のように、find(4) のプロセスで経路圧縮を行い、木の階層を少なくすることができます。
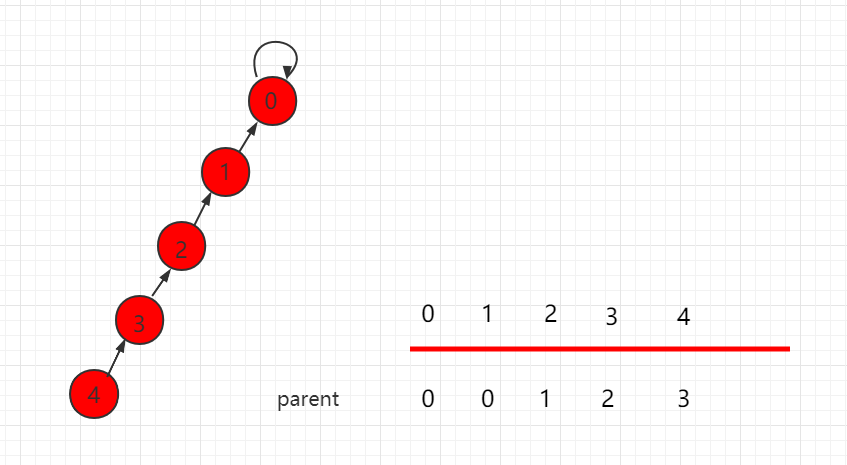
ノード 4 がルートノードを上に向かって探すとき、最初の圧縮ステップで、木の階層が1つ減ります:
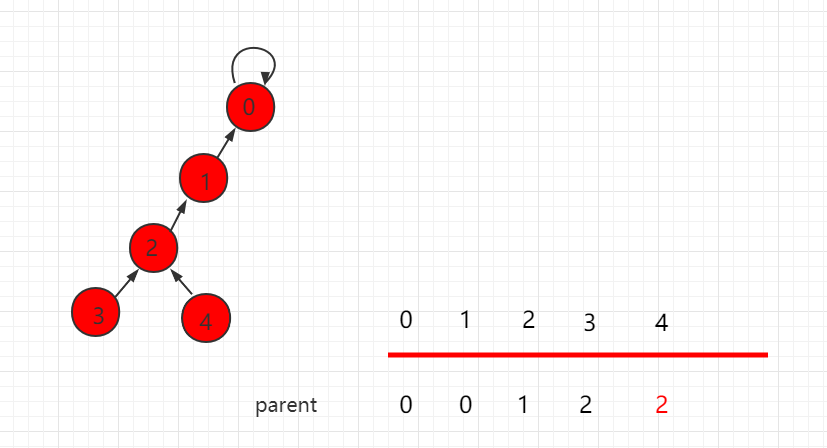
ノード 2 が上に向かって探しても、ルートノードではないので、要素 2 を元の親ノードの親ノードを指すようにします。操作後、木の階層は対応して1層減り、同時にルートノード 0 を返します。
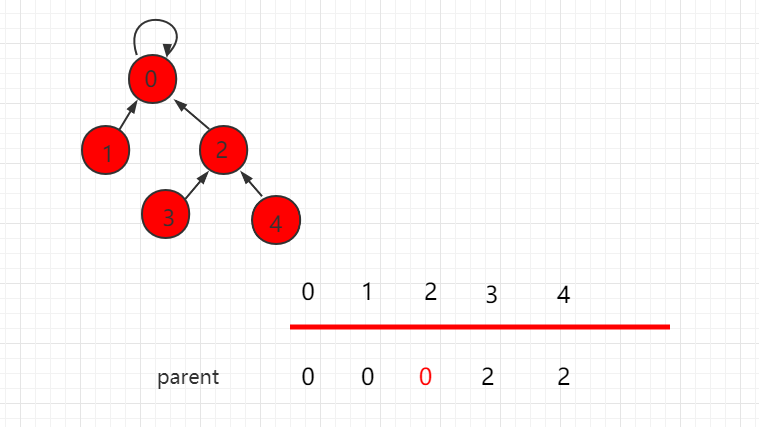
find プロセスのコードを次のように変更します:
// 検索プロセス、要素 p に対応する集合の番号を検索します
// O(h) 計算量、h は木の高さ
private int find(int p){
assert( p >= 0 && p < count );
// path compression 1
while( p != parent[p] ){
parent[p] = parent[parent[p]];
p = parent[p];
}
return p;
}
// O(h) 計算量、h は木の高さ
private int find(int p){
assert( p >= 0 && p < count );
// path compression 1
while( p != parent[p] ){
parent[p] = parent[parent[p]];
p = parent[p];
}
return p;
}
上記の経路圧縮は最適な方法ではありません。最初の木を下の図のように圧縮すると、階層が最小になります。
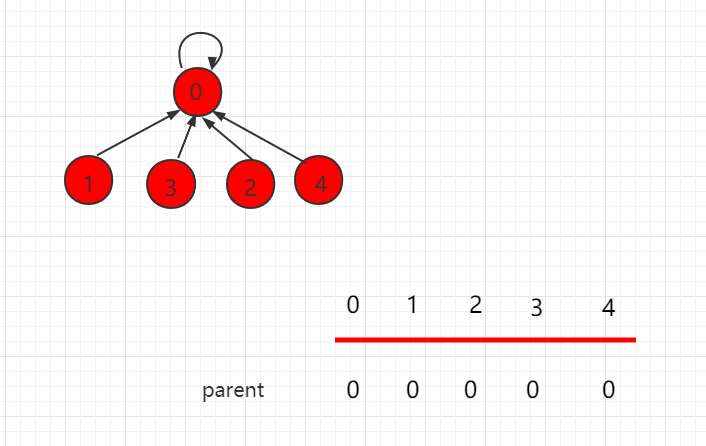
この find プロセスは次のように表せます:
...
// 検索プロセス、要素 p に対応する集合の番号を検索します
// O(h) 計算量、h は木の高さ
private int find(int p) {
assert (p >= 0 && p < count);
// 2番目の経路圧縮アルゴリズム
if (p != parent[p])
parent[p] = find(parent[p]);
return parent[p];
}
...
// 検索プロセス、要素 p に対応する集合の番号を検索します
// O(h) 計算量、h は木の高さ
private int find(int p) {
assert (p >= 0 && p < count);
// 2番目の経路圧縮アルゴリズム
if (p != parent[p])
parent[p] = find(parent[p]);
return parent[p];
}
...
Java サンプルコード
ソースコードパッケージのダウンロード:Download
UnionFind3.java ファイルのコード:
package サンプル.union;
/**
* rank に基づく最適化
*/
public class UnionFind4 {
private int[] rank; // rank[i] は、i をルートとする集合が表す木の階層数を示します
private int[] parent; // parent[i] は、i 番目の要素が指す親ノードを示します
private int count; // データ数
// コンストラクタ
public UnionFind4(int count){
rank = new int[count];
parent = new int[count];
this.count = count;
// 初期化、各 parent[i] は自分自身を指します。つまり、各要素がそれ自体で1つの集合を形成することを示します。
for( int i = 0 ; i < count ; i ++ ){
parent[i] = i;
rank[i] = 1;
}
}
// 検索プロセス、要素 p に対応する集合の番号を検索します
// O(h) 計算量、h は木の高さ
private int find(int p){
assert( p >= 0 && p < count );
// ルートノードに到達するまで、自分の親ノードを繰り返し照会します
// ルートノードの特徴: parent[p] == p
while( p != parent[p] )
p = parent[p];
return p;
// 2番目の経路圧縮アルゴリズム
//if( p != parent[p] )
//parent[p] = find( parent[p] );
//return parent[p];
}
// 要素 p と要素 q が同じ集合に属するかどうかを確認します
// O(h) 計算量、h は木の高さ
public boolean isConnected( int p , int q ){
return find(p) == find(q);
}
// 要素 p と要素 q が属する集合をマージします
// O(h) 計算量、h は木の高さ
public void unionElements(int p, int q){
int pRoot = find(p);
int qRoot = find(q);
if( pRoot == qRoot )
return;
if( rank[pRoot] < rank[qRoot] ){
parent[pRoot] = qRoot;
}
else if( rank[qRoot] < rank[pRoot]){
parent[qRoot] = pRoot;
}
else{ // rank[pRoot] == rank[qRoot]
parent[pRoot] = qRoot;
rank[qRoot] += 1; // rank の値を維持します
}
}
}
/**
* rank に基づく最適化
*/
public class UnionFind4 {
private int[] rank; // rank[i] は、i をルートとする集合が表す木の階層数を示します
private int[] parent; // parent[i] は、i 番目の要素が指す親ノードを示します
private int count; // データ数
// コンストラクタ
public UnionFind4(int count){
rank = new int[count];
parent = new int[count];
this.count = count;
// 初期化、各 parent[i] は自分自身を指します。つまり、各要素がそれ自体で1つの集合を形成することを示します。
for( int i = 0 ; i < count ; i ++ ){
parent[i] = i;
rank[i] = 1;
}
}
// 検索プロセス、要素 p に対応する集合の番号を検索します
// O(h) 計算量、h は木の高さ
private int find(int p){
assert( p >= 0 && p < count );
// ルートノードに到達するまで、自分の親ノードを繰り返し照会します
// ルートノードの特徴: parent[p] == p
while( p != parent[p] )
p = parent[p];
return p;
// 2番目の経路圧縮アルゴリズム
//if( p != parent[p] )
//parent[p] = find( parent[p] );
//return parent[p];
}
// 要素 p と要素 q が同じ集合に属するかどうかを確認します
// O(h) 計算量、h は木の高さ
public boolean isConnected( int p , int q ){
return find(p) == find(q);
}
// 要素 p と要素 q が属する集合をマージします
// O(h) 計算量、h は木の高さ
public void unionElements(int p, int q){
int pRoot = find(p);
int qRoot = find(q);
if( pRoot == qRoot )
return;
if( rank[pRoot] < rank[qRoot] ){
parent[pRoot] = qRoot;
}
else if( rank[qRoot] < rank[pRoot]){
parent[qRoot] = pRoot;
}
else{ // rank[pRoot] == rank[qRoot]
parent[pRoot] = qRoot;
rank[qRoot] += 1; // rank の値を維持します
}
}
}