Structure de graphe SciPy
La structure de graphe est l'un des cadres les plus puissants de l'algorithmique.
Un graphe est un ensemble de nœuds et d'arêtes de diverses relations. Les nœuds sont des sommets correspondant à des objets, et les arêtes sont des connexions entre les objets.
SciPy fournit le module scipy.sparse.csgraph pour gérer les structures de graphe.
Matrice d'adjacence
Une matrice d'adjacence est une matrice qui représente les relations d'adjacence entre les sommets.
La structure logique d'une matrice d'adjacence est divisée en deux parties : les ensembles V et E, où V désigne les sommets et E les arêtes. Les arêtes ont parfois des poids, représentant la force de connexion entre les nœuds.
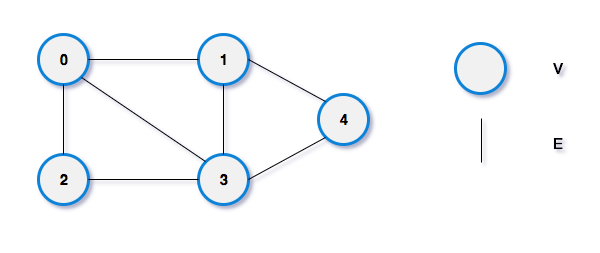
Un tableau à une dimension est utilisé pour stocker toutes les données des sommets du graphe, et un tableau à deux dimensions est utilisé pour stocker les données des relations entre les sommets (arêtes ou arcs). Ce tableau à deux dimensions est appelé matrice d'adjacence.
Regardez l'exemple suivant :
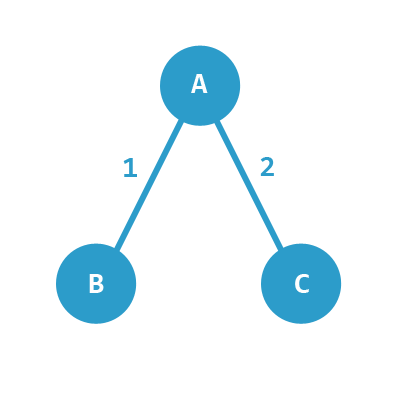
Les sommets sont A, B, C, et les poids des arêtes sont 1 et 2.
A et B sont connectés avec un poids de 1.
A et C sont connectés avec un poids de 2.
C et B ne sont pas connectés.
Cette matrice d'adjacence peut être représentée par le tableau à deux dimensions suivant :
     A B C
   A:[0 1 2]
   B:[1 0 0]
   C:[2 0 0]
Les matrices d'adjacence se divisent en outre en matrices d'adjacence de graphe orienté et matrices d'adjacence de graphe non orienté.
Un graphe non orienté est une relation bidirectionnelle, et les arêtes n'ont pas de direction :
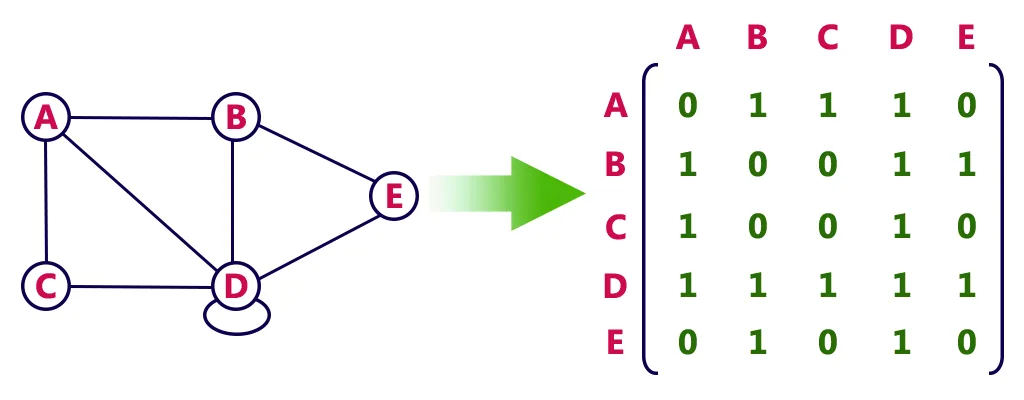
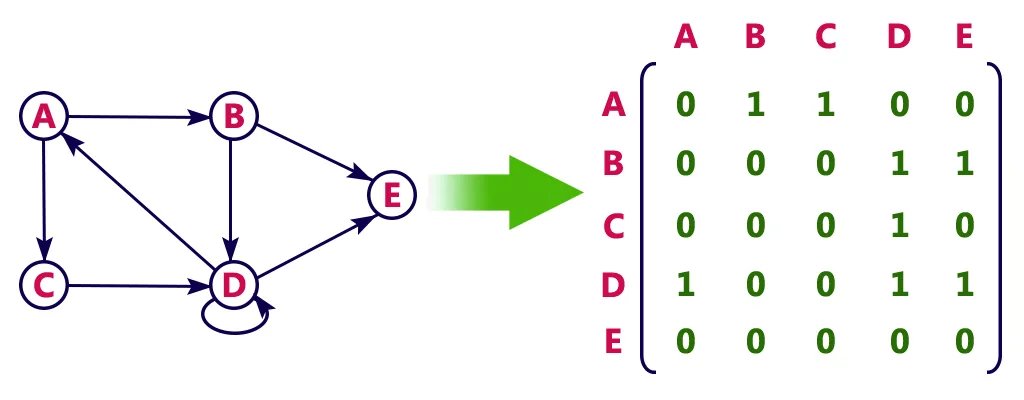
Remarque :Le nœud D dans les deux figures ci-dessus est une auto-boucle. Une auto-boucle signifie que les deux extrémités d'une arête sont le même nœud.
Composantes connexes
Utilisez la méthode connected_components() pour afficher toutes les composantes connexes.
Exemple
from scipy.sparse.csgraph import connected_components
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 2],
[1, 0, 0],
[2, 0, 0]
])
newarr = csr_matrix(arr)
print(connected_components(newarr))
La sortie du code ci-dessus est :
(1, array([0, 0, 0], dtype=int32))
Dijkstra -- Algorithme du plus court chemin
L'algorithme du plus court chemin de Dijkstra est utilisé pour calculer les plus courts chemins d'un nœud vers tous les autres nœuds.
SciPy utilise la méthode dijkstra() pour calculer le plus court chemin d'un élément vers d'autres éléments.
La méthode dijkstra() peut définir les paramètres suivants :- return_predecessors:Une valeur booléenne. Définissez-la sur True pour parcourir tous les chemins ; si vous ne voulez pas parcourir tous les chemins, définissez-la sur False.
- indices:L'indice de l'élément, renvoyant tous les chemins à partir de cet élément.
- limit:Le poids maximal des chemins.
Exemple
Trouvez le chemin le plus court de l'élément 1 à l'élément 2 :
from scipy.sparse.csgraph import dijkstra
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 2],
[1, 0, 0],
[2, 0, 0]
])
newarr = csr_matrix(arr)
print(dijkstra(newarr, return_predecessors=True, indices=0))
La sortie du code ci-dessus est :
(array([ 0., 1., 2.]), array([-9999, 0, 0], dtype=int32))
Floyd Warshall -- Algorithme de Floyd
L'algorithme de Floyd est un algorithme pour résoudre le chemin le plus court entre deux points quelconques.
SciPy utilise la méthode floyd_warshall() pour trouver le chemin le plus court entre toutes les paires d'éléments.
Exemple
Trouvez les chemins les plus courts entre toutes les paires d'éléments :
from scipy.sparse.csgraph import floyd_warshall
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 2],
[1, 0, 0],
[2, 0, 0]
])
newarr = csr_matrix(arr)
print(floyd_warshall(newarr, return_predecessors=True))
La sortie du code ci-dessus est :
(array([[ 0.,  1.,  2.],
       [ 1.,  0.,  3.],
       [ 2.,  3.,  0.]]), array([[-9999,     0,     0],
       [    1, -9999,     0],
       [    2,     0, -9999]], dtype=int32))
Bellman Ford -- Algorithme de Bellman-Ford
L'algorithme de Bellman-Ford est un algorithme permettant de résoudre le plus court chemin entre deux points quelconques.
SciPy utilise la méthode bellman_ford() pour trouver le plus court chemin entre toutes les paires d'éléments. Elle peut généralement être utilisée dans n'importe quel graphe, y compris les graphes orientés et les graphes avec des arêtes de poids négatif.
Exemple
Utilisez un graphe avec des arêtes de poids négatif pour trouver le plus court chemin de l'élément 1 à l'élément 2 :
from scipy.sparse.csgraph import bellman_ford
from scipy.sparse import csr_matrix
arr = np.array([
[0, -1, 2],
[1, 0, 0],
[2, 0, 0]
])
newarr = csr_matrix(arr)
print(bellman_ford(newarr, return_predecessors=True, indices=0))
La sortie du code ci-dessus est :
(array([ 0., -1., 2.]), array([-9999, 0, 0], dtype=int32))
Ordre de parcours en profondeur
La méthode depth_first_order() renvoie l'ordre de parcours en profondeur à partir d'un nœud.
Elle peut accepter les paramètres suivants :
- Graphe
- L'élément à partir duquel le parcours du graphe commence
Exemple
Étant donné une matrice d'adjacence, renvoyer l'ordre de parcours en profondeur :
from scipy.sparse.csgraph import depth_first_order
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 0, 1],
[1, 1, 1, 1],
[2, 1, 1, 0],
[0, 1, 0, 1]
])
newarr = csr_matrix(arr)
print(depth_first_order(newarr, 1))
La sortie du code ci-dessus est :
(array([1, 0, 3, 2], dtype=int32), array([ 1, -9999, 1, 0], dtype=int32))
Ordre en largeur
La méthode breadth_first_order() renvoie l'ordre de parcours en largeur à partir d'un nœud.
Elle peut accepter les paramètres suivants :
- Graphe
- L'élément à partir duquel le parcours du graphe commence
Exemple
Étant donné une matrice d'adjacence, renvoyer l'ordre de parcours en largeur :
from scipy.sparse.csgraph import breadth_first_order
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 0, 1],
[1, 1, 1, 1],
[2, 1, 1, 0],
[0, 1, 0, 1]
])
newarr = csr_matrix(arr)
print(breadth_first_order(newarr, 1))
La sortie du code ci-dessus est :
(array([1, 0, 2, 3], dtype=int32), array([ 1, -9999, 1, 1], dtype=int32))Autres extensions