SciPy-Graphstruktur
Graphstruktur ist eines der mächtigsten Frameworks in der Algorithmik.
Ein Graph ist eine Sammlung von Knoten und Kanten verschiedener Beziehungen. Knoten sind Eckpunkte, die Objekten entsprechen, und Kanten sind Verbindungen zwischen Objekten.
SciPy stellt das Modul scipy.sparse.csgraph bereit, um Graphstrukturen zu verarbeiten.
Adjazenzmatrix
Eine Adjazenzmatrix ist eine Matrix, die die Adjazenzbeziehungen zwischen Knoten darstellt.
Die logische Struktur einer Adjazenzmatrix ist in zwei Teile unterteilt: die Mengen V und E, wobei V für Knoten und E für Kanten steht. Kanten haben manchmal Gewichte, die die Verbindungsstärke zwischen Knoten darstellen.
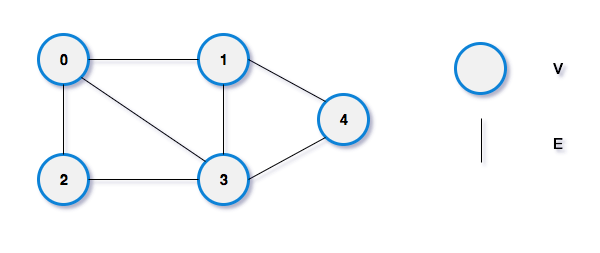
Ein eindimensionales Array wird verwendet, um alle Knotendaten im Graphen zu speichern, und ein zweidimensionales Array wird verwendet, um die Daten der Beziehungen zwischen Knoten (Kanten oder Bögen) zu speichern. Dieses zweidimensionale Array wird Adjazenzmatrix genannt.
Betrachten Sie das folgende Beispiel:
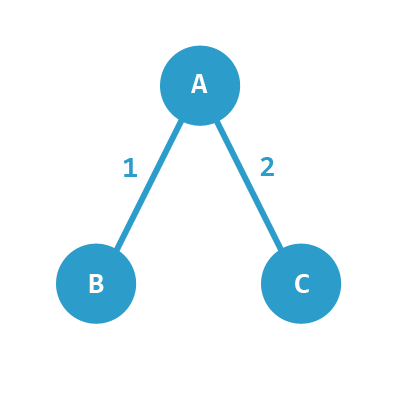
Die Knoten sind A, B, C, und die Kantengewichte sind 1 und 2.
A und B sind mit Gewicht 1 verbunden.
A und C sind mit Gewicht 2 verbunden.
C und B sind nicht verbunden.
Diese Adjazenzmatrix kann als das folgende zweidimensionale Array dargestellt werden:
     A B C
   A:[0 1 2]
   B:[1 0 0]
   C:[2 0 0]
Adjazenzmatrizen werden weiter in Adjazenzmatrizen für gerichtete Graphen und Adjazenzmatrizen für ungerichtete Graphen unterteilt.
Ein ungerichteter Graph ist eine bidirektionale Beziehung, und Kanten haben keine Richtung:
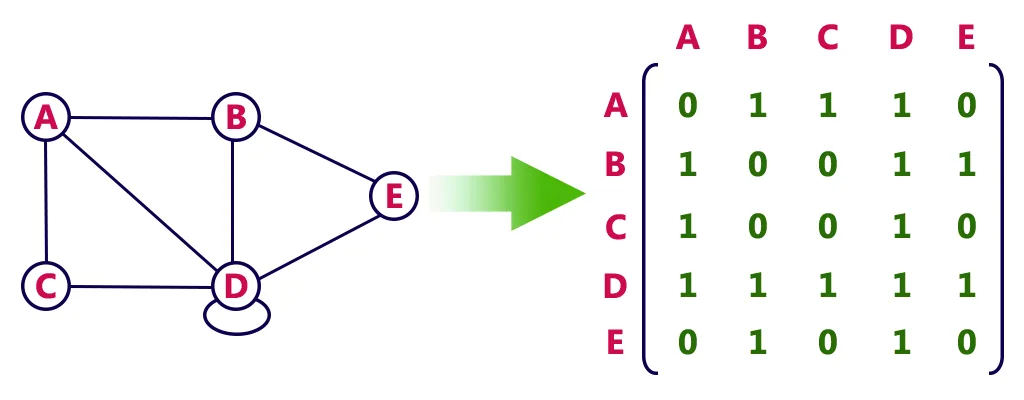
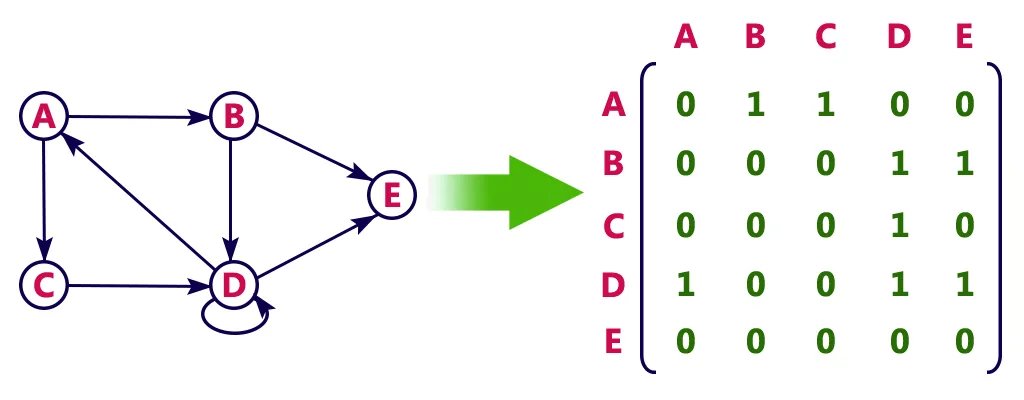
Hinweis:Der Knoten D in den beiden obigen Abbildungen ist eine Selbstschleife. Eine Selbstschleife bedeutet, dass beide Enden einer Kante derselbe Knoten sind.
Zusammenhangskomponenten
Verwenden Sie die Methode connected_components(), um alle Zusammenhangskomponenten anzuzeigen.
Beispiel
from scipy.sparse.csgraph import connected_components
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 2],
[1, 0, 0],
[2, 0, 0]
])
newarr = csr_matrix(arr)
print(connected_components(newarr))
Die Ausgabe des obigen Codes ist:
(1, array([0, 0, 0], dtype=int32))
Dijkstra -- Algorithmus für kürzeste Wege
Dijkstras Algorithmus für kürzeste Wege wird verwendet, um die kürzesten Wege von einem Knoten zu allen anderen Knoten zu berechnen.
SciPy verwendet die Methode dijkstra(), um den kürzesten Weg von einem Element zu anderen Elementen zu berechnen.
Mit der Methode dijkstra() können die folgenden Parameter festgelegt werden:- return_predecessors:Ein boolescher Wert. Setzen Sie ihn auf True, um alle Pfade zu durchlaufen; wenn Sie nicht alle Pfade durchlaufen möchten, setzen Sie ihn auf False.
- indices:Der Index des Elements, der alle Pfade von diesem Element zurückgibt.
- limit:Das maximale Gewicht der Pfade.
Beispiel
Finden Sie den kürzesten Pfad von Element 1 zu Element 2:
from scipy.sparse.csgraph import dijkstra
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 2],
[1, 0, 0],
[2, 0, 0]
])
newarr = csr_matrix(arr)
print(dijkstra(newarr, return_predecessors=True, indices=0))
Die Ausgabe des obigen Codes ist:
(array([ 0., 1., 2.]), array([-9999, 0, 0], dtype=int32))
Floyd Warshall -- Floyds Algorithmus
Floyds Algorithmus ist ein Algorithmus zur Lösung des kürzesten Pfads zwischen zwei beliebigen Punkten.
SciPy verwendet die Methode floyd_warshall(), um den kürzesten Pfad zwischen allen Elementpaaren zu finden.
Beispiel
Finden Sie die kürzesten Pfade zwischen allen Elementpaaren:
from scipy.sparse.csgraph import floyd_warshall
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 2],
[1, 0, 0],
[2, 0, 0]
])
newarr = csr_matrix(arr)
print(floyd_warshall(newarr, return_predecessors=True))
Die Ausgabe des obigen Codes ist:
(array([[ 0.,  1.,  2.],
       [ 1.,  0.,  3.],
       [ 2.,  3.,  0.]]), array([[-9999,     0,     0],
       [    1, -9999,     0],
       [    2,     0, -9999]], dtype=int32))
Bellman Ford -- Bellman-Ford-Algorithmus
Der Bellman-Ford-Algorithmus ist ein Algorithmus zur Bestimmung des kürzesten Pfads zwischen zwei beliebigen Punkten.
SciPy verwendet die Methode bellman_ford(), um den kürzesten Pfad zwischen allen Paaren von Elementen zu finden. Sie kann im Allgemeinen in jedem Graphen verwendet werden, einschließlich gerichteter Graphen und Graphen mit negativ gewichteten Kanten.
Beispiel
Verwenden Sie einen Graphen mit negativ gewichteten Kanten, um den kürzesten Pfad von Element 1 zu Element 2 zu finden:
from scipy.sparse.csgraph import bellman_ford
from scipy.sparse import csr_matrix
arr = np.array([
[0, -1, 2],
[1, 0, 0],
[2, 0, 0]
])
newarr = csr_matrix(arr)
print(bellman_ford(newarr, return_predecessors=True, indices=0))
Die Ausgabe des obigen Codes ist:
(array([ 0., -1., 2.]), array([-9999, 0, 0], dtype=int32))
Tiefensuche-Reihenfolge
Die Methode depth_first_order() gibt die Reihenfolge des Tiefendurchlaufs von einem Knoten zurück.
Sie kann die folgenden Parameter akzeptieren:
- Graph
- Das Element, von dem aus der Graphdurchlauf beginnt
Beispiel
Geben Sie bei gegebener Adjazenzmatrix die Reihenfolge des Tiefendurchlaufs zurück:
from scipy.sparse.csgraph import depth_first_order
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 0, 1],
[1, 1, 1, 1],
[2, 1, 1, 0],
[0, 1, 0, 1]
])
newarr = csr_matrix(arr)
print(depth_first_order(newarr, 1))
Die Ausgabe des obigen Codes ist:
(array([1, 0, 3, 2], dtype=int32), array([ 1, -9999, 1, 0], dtype=int32))
Breitensuche-Reihenfolge
Die Methode breadth_first_order() gibt die Breitensuche-Traversierungsreihenfolge von einem Knoten zurück.
Sie kann die folgenden Parameter akzeptieren:
- Graph
- Das Element, von dem aus der Graphdurchlauf beginnt
Beispiel
Geben Sie für eine Adjazenzmatrix die Breitensuche-Traversierungsreihenfolge zurück:
from scipy.sparse.csgraph import breadth_first_order
from scipy.sparse import csr_matrix
arr = np.array([
[0, 1, 0, 1],
[1, 1, 1, 1],
[2, 1, 1, 0],
[0, 1, 0, 1]
])
newarr = csr_matrix(arr)
print(breadth_first_order(newarr, 1))
Die Ausgabe des obigen Codes ist:
(array([1, 0, 2, 3], dtype=int32), array([ 1, -9999, 1, 1], dtype=int32))Andere Erweiterungen