XML DOM - Knoten navigieren
Sie können zwischen Knoten navigieren, indem Sie die Beziehungen zwischen Knoten verwenden.
Navigieren in DOM-Knoten
Der Zugriff auf Knoten im Knotenbaum über die Beziehungen zwischen Knoten wird üblicherweise als "Navigieren in Knoten" bezeichnet.
Im XML DOM werden Knotenbeziehungen als Eigenschaften von Knoten definiert:
- parentNode
- childNodes
- firstChild
- lastChild
- nextSibling
- previousSibling
Das Bild unten veranschaulichteinen Teil des Knotenbaums und veranschaulicht die Beziehungen zwischen Knoten:
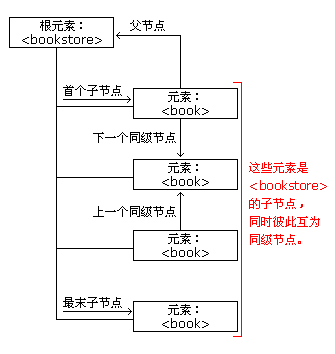
DOM - Übergeordnete Knoten
Jeder Knoten hat nur einen übergeordneten Knoten. Der folgende Code navigiert zum übergeordneten Knoten von <book>:
Beispiel
Selbst ausprobieren »
Beispielerklärung:
- VerwendungloadXMLDoc()put "" Laden in xmlDoc
- Das erste <book>-Element abrufen
- Gib den Knotennamen des Elternknotens von "x" aus
Leere Textknoten vermeiden
Firefox und einige andere Browser behandeln leeren Leerraum oder Zeilenumbrüche als Textknoten, während Internet Explorer das nicht tut.
Dies führt zu einem Problem bei der Verwendung der folgenden Eigenschaften: firstChild, lastChild, nextSibling, previousSibling.
Um das Navigieren zu leeren Textknoten (Leerzeichen und Zeilenumbrüche zwischen Elementknoten) zu vermeiden, verwenden wir eine Funktion zur Überprüfung des Knotentyps:
function get_nextSibling(n)
{
  y=n.nextSibling;
  while (y.nodeType!=1)
  {
    y=y.nextSibling;
  }
  return y;
}
Die obige Funktion ermöglicht es Ihnen, get_nextSibling(node) anstelle vonnode.nextSibling-Eigenschaft zu verwenden.
Code-Erklärung:
Der Elementknotentyp ist 1. Wenn ein Geschwisterknoten kein Elementknoten ist, gehe zum nächsten Knoten, bis ein Elementknoten gefunden wird. Auf diese Weise kann sowohl im Internet Explorer als auch in Firefox dasselbe Ergebnis erzielt werden.
Abrufen des ersten Kindelements
Der folgende Code zeigt das erste Element des ersten <book>:
Beispiel
Ausgabe:
Selbst ausprobieren »
Beispielerklärung:
- VerwendungloadXMLDoc()put "" Laden in xmlDoc
- Verwenden Sie die Funktion get_firstChild für das erste <book>-Element, um den ersten Kindknoten abzurufen (der ein Elementknoten ist)
- Geben Sie den Knotennamen des ersten Kindknotens aus (der ein Elementknoten ist)

Weitere Beispiele
Dieses Beispiel verwendet die Methode lastChild() und eine benutzerdefinierte Funktion, um den letzten Kindknoten eines Knotens abzurufen
Dieses Beispiel verwendet die Methode nextSibling() und eine benutzerdefinierte Funktion, um den nächsten Geschwisterknoten eines Knotens abzurufen
Dieses Beispiel verwendet die Methode previousSibling() und eine benutzerdefinierte Funktion, um den vorherigen Geschwisterknoten eines Knotens abzurufen
Weitere Erweiterungen