XML DOM - ノードのナビゲーション
ノード間の関係を使用してノードをナビゲートできます。
DOMノードのナビゲーション
ノード間の関係を通じてノードツリー内のノードにアクセスすることは、通常、ノードのナビゲーション("navigating nodes")と呼ばれます。
XML DOM では、ノードの関係はノードの属性として定義されます:
- parentNode
- childNodes
- firstChild
- lastChild
- nextSibling
- previousSibling
以下の図は、ノードツリーの一部を示し、ノード間の関係を説明しています:
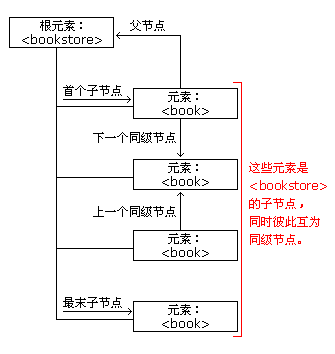
DOM - 親ノード
すべてのノードには親ノードが1つだけあります。次のコードは <book> の親ノードへナビゲートします:
例
試してみる »
例の説明:
- 使用してloadXMLDoc()「」を xmlDoc に読み込みます
- 最初の <book> 要素を取得します
- "x" の親ノードのノード名を出力します
空のテキストノードを回避する
Firefox および他の一部のブラウザは、空の空白または改行をテキストノードとして扱いますが、Internet Explorer はそうしません。
これにより、firstChild、lastChild、nextSibling、previousSibling という属性を使用するときに問題が発生します。
空のテキストノード(要素ノード間のスペースや改行)へのナビゲーションを避けるために、ノードタイプを確認する関数を使用します:
function get_nextSibling(n)
{
  y=n.nextSibling;
  while (y.nodeType!=1)
  {
    y=y.nextSibling;
  }
  return y;
}
上記の関数を使用すると、get_nextSibling(node)の代わりにnode.nextSibling プロパティを使用できます。
コードの説明:
要素ノードのタイプは 1 です。兄弟ノードが要素ノードでない場合は、要素ノードが見つかるまで次のノードに移動します。この方法により、Internet Explorer と Firefox の両方で同じ結果を得ることができます。
最初の子要素を取得する
次のコードは、最初の <book> の最初の要素を表示します:
例
出力:
試してみる »
例の説明:
- 使用してloadXMLDoc()「」を xmlDoc に読み込みます
- 最初の <book> 要素に対して get_firstChild 関数を使用して、最初の子ノード(要素ノード)を取得します
- 最初の子ノード(要素ノード)のノード名を出力します

その他の例
この例では、lastChild() メソッドとカスタム関数を使用して、ノードの最後の子ノードを取得します。
この例では、nextSibling() メソッドとカスタム関数を使用して、ノードの次の兄弟ノードを取得します。
この例では、previousSibling() メソッドとカスタム関数を使用して、ノードの前の兄弟ノードを取得します。
その他の拡張