SciPy 空間データ
空間データは幾何データとも呼ばれ、物体の位置、形状、大きさの分布など、さまざまな情報を表すために使われます。例えば、座標上の点などです。
SciPy は scipy.spatial モジュールを通じて空間データを処理します。例えば、点が境界内にあるかどうかの判定、指定された点の周囲で最も近い点の計算、指定された距離内のすべての点の計算などです。
三角測量
三角測量は、三角法と幾何学において、目標点と固定基準線の既知の端点との角度を測定することによって、目標の距離を測定する方法です。
多角形の三角形分割は、多角形を複数の三角形に分割することであり、これらの三角形を使って多角形の面積を計算できます。
トポロジーの既知の事実として、あらゆる曲面には三角形分割が存在します。
曲面上に三角形分割があると仮定します。すべての三角形の頂点の総数を p(共通の頂点は1つと数える)、辺の数を a、三角形の数を n とすると、e = p - a + n は曲面の位相不変量です。つまり、どのような分割であっても、e は常に同じ値になります。この e はオイラー標数と呼ばれます。
一連の点に対する三角形分割の方法は、Delaunay() 三角形分割です。
サンプル
指定された点を使って三角形を作成します:
from scipy.spatial import Delaunay
import matplotlib.pyplot as plt
points = np.array([
[2, 4],
[3, 4],
[3, 0],
[2, 2],
[4, 1]
])
simplices = Delaunay(points).simplices # 三角形内の頂点のインデックス
plt.triplot(points[:, 0], points[:, 1], simplices)
plt.scatter(points[:, 0], points[:, 1], color='r')
plt.show()
出力結果は次の図のようになります:
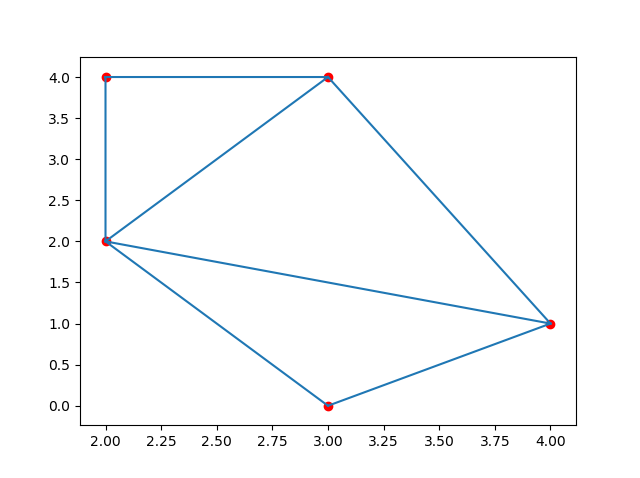
注:三角形の頂点の id は、三角形分割オブジェクトの simplices 属性に格納されます。
凸包
凸包(Convex Hull)は、計算幾何学(グラフィックス)における概念です。
実数ベクトル空間 V において、与えられた集合 X について、X を含むすべての凸集合の共通部分 S を X の凸包と呼びます。X の凸包は、X 内のすべての点 (X1,...Xn) の凸結合によって構成できます。
ConvexHull() メソッドを使用して凸包を作成できます。
サンプル
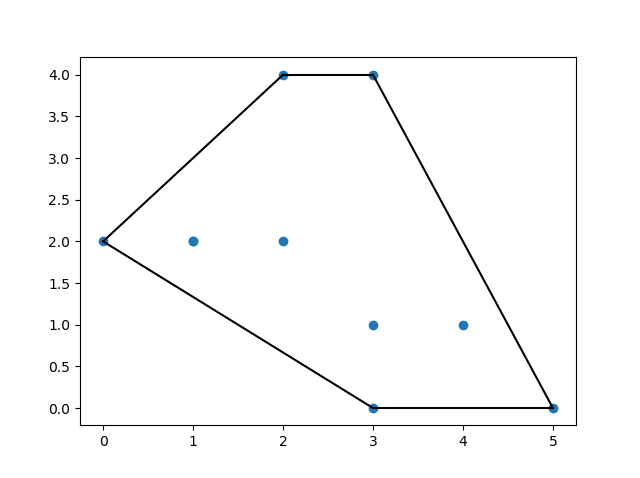
指定された点を使って凸包を作成します:
from scipy.spatial import ConvexHull
import matplotlib.pyplot as plt
points = np.array([
[2, 4],
[3, 4],
[3, 0],
[2, 2],
[4, 1],
[1, 2],
[5, 0],
[3, 1],
[1, 2],
[0, 2]
])
hull = ConvexHull(points)
hull_points = hull.simplices
plt.scatter(points[:,0], points[:,1])
for simplex in hull_points:
plt.plot(points[simplex,0], points[simplex,1], 'k-')
plt.show()
出力結果は次の図のようになります:
K-D 木
kd-tree(k-dimensional tree の略)は、k次元空間のデータ点を格納し、高速に検索するための木構造データ構造です。主に多次元空間のキーデータの検索(例:範囲検索や最近傍検索)に適用されます。
K-D 木は、多次元キー検索(範囲検索や最近傍検索)など、さまざまな用途で使用できます。
最近傍検索は、ツリー内で入力点に最も近い点を見つけるために使用されます。
KDTree()このメソッドは KDTree オブジェクトを返します。
query()このメソッドは最近傍距離と最近傍位置を返します。
サンプル
(1,1) への最近傍距離を求めます:
points = [(1, -1), (2, 3), (-2, 3), (2, -3)]
kdtree = KDTree(points)
res = kdtree.query((1, 1))
print(res)
出力結果は次の図のようになります:
(2.0, 0)
距離行列
数学において、距離行列は、各要素が点間の距離である行列(2次元配列)です。したがって、ユークリッド空間内の N 個の点が与えられた場合、その距離行列は非負実数を要素とするN×N対称行列です。距離行列と隣接行列の概念は似ており、その違いは、後者が要素(点)間に辺があるかどうかだけを含み、要素(点)間の接続距離の情報を含まないことです。したがって、距離行列は隣接行列の重み付き形式と見なすことができます。
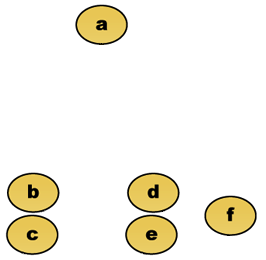
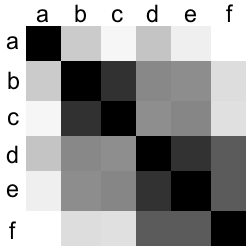
例えば、次の2次元の点 a から f を分析します。ここでは、点が存在するピクセル間のユークリッド距離を距離尺度とします。
その距離行列は次のとおりです:
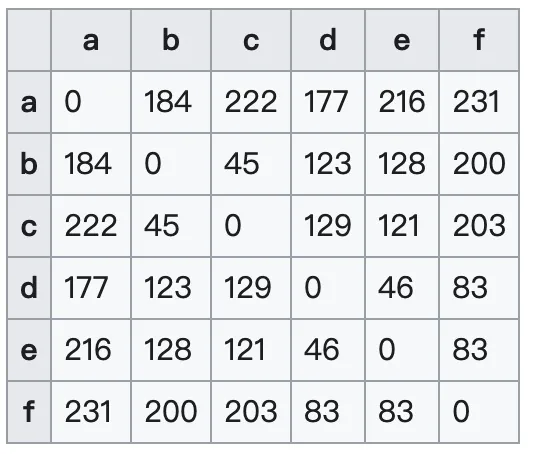
距離行列のこれらのデータは、さらにグラフィカル表現のヒートマップ(下図参照)として見ることができます。ここで、黒は距離がゼロであることを表し、白は最大距離を表します。
バイオインフォマティクスでは、距離行列は、座標系に依存しないタンパク質構造や、配列空間における2つの配列間の距離を表すために使用されます。これらの表現は、構造アラインメント、配列アラインメント、さらに核磁気共鳴、X線、結晶学におけるタンパク質構造の決定に使用されます。
ユークリッド距離
数学において、ユークリッド距離またはユークリッド距離関数は、ユークリッド空間内の2点間の「通常の」(つまり直線)距離です。この距離を使用すると、ユークリッド空間は距離空間になります。関連するノルムはユークリッドノルムと呼ばれます。初期の文献ではピタゴラス距離と呼ばれていました。
ユークリッド計量(euclidean metric)(ユークリッド距離とも呼ばれる)は、通常採用される距離の定義であり、m次元空間における2点間の実際の距離、またはベクトルの自然な長さ(つまり、その点から原点までの距離)を指します。2次元および3次元空間でのユークリッド距離は、2点間の実際の距離です。
次の例では、指定された点間のユークリッド距離を確認します:
サンプル
p1 = (1, 0)
p2 = (10, 2)
res = euclidean(p1, p2)
print(res)
出力結果は次の図のようになります:
9.21954445729
マンハッタン距離
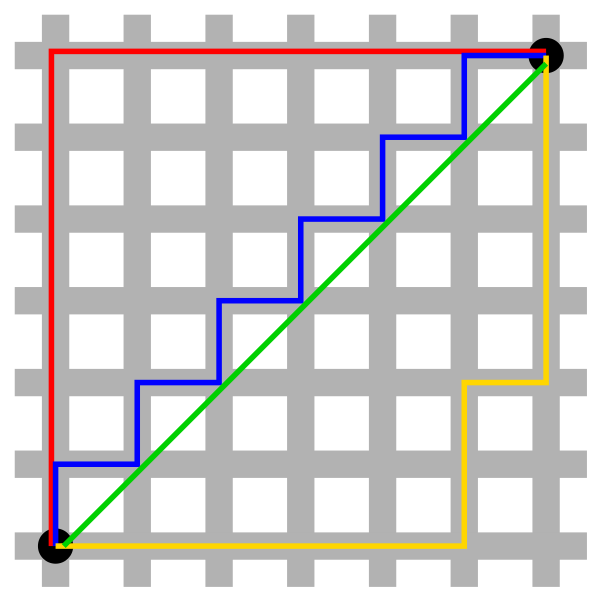
タクシー幾何学またはマンハッタン距離(Manhattan Distance)は、19世紀のヘルマン・ミンコフスキーによって作られた語で、幾何学的距離空間で使用される幾何学用語であり、標準座標系における2点間の絶対軸距離の合計を表します。
マンハッタン距離では、移動は上下左右の4方向のみで、2点間のマンハッタン距離は2点間の最短距離です。
マンハッタン距離とユークリッド距離: 赤、青、黄の線は、すべてのマンハッタン距離が同じ長さ(12)であることを示し、緑の線はユークリッド距離が 6×√2 ≈ 8.48 の長さであることを示します。
次の例では、与えられた点のマンハッタン距離を計算します:
サンプル
p1 = (1, 0)
p2 = (10, 2)
res = cityblock(p1, p2)
print(res)
出力結果は次のとおりです:
11
コサイン距離
コサイン距離は、コサイン類似度とも呼ばれ、2つのベクトルのなす角のコサイン値を測定して、それらの間の類似性を測定します。
0度の角のコサイン値は 1 であり、他のどの角度のコサイン値も 1 を超えず、その最小値は -1 です。
次の例では、A と B の2点間のコサイン距離を計算します:
サンプル
p1 = (1, 0)
p2 = (10, 2)
res = cosine(p1, p2)
print(res)
出力結果は次のとおりです:
0.019419324309079777
ハミング距離
情報理論において、2つの等しい長さの文字列間のハミング距離(英語: Hamming distance)は、2つの文字列の対応する位置にある異なる文字の数です。言い換えると、ある文字列を別の文字列に変換するために置換する必要がある文字の数です。
ハミング重みは、文字列と同長のゼロ文字列とのハミング距離であり、つまり、文字列内の非ゼロ要素の数です。バイナリ文字列の場合、それは 1 の数であり、11101 のハミング重みは 4 です。
- 1011101と1001001の間のハミング距離は 2 です。
- 2143896と2233796の間のハミング距離は 3 です。
- "tonedとrosesの間のハミング距離は 3 です。
次の例では、2点間のハミング距離を計算します:
サンプル
p1 = (True, False, True)
p2 = (False, True, True)
res = hamming(p1, p2)
print(res)
出力結果は次のとおりです:
0.666666666667その他の拡張