Despliegue de modelos PyTorch
El despliegue de modelos es el proceso de poner en producción un modelo de aprendizaje automático entrenado. PyTorch ofrece múltiples herramientas y métodos para lograr este objetivo.
¿Por qué es necesario el despliegue de modelos?
- Integración de aplicaciones: integrar capacidades de IA en sistemas web, móviles o embebidos
- Optimización del rendimiento: optimizar la velocidad de inferencia del modelo para entornos de producción
- Gestión de recursos: utilizar eficazmente los recursos computacionales para lograr servicios de alta concurrencia
Descripción general del proceso de despliegue
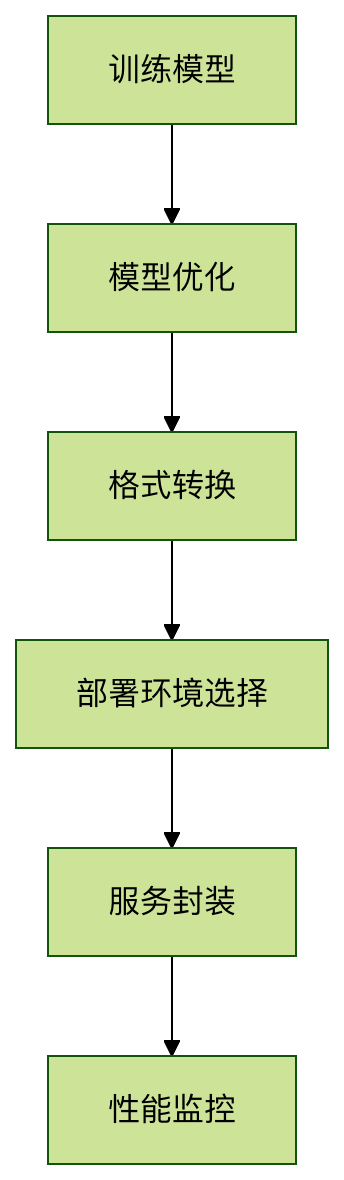
Preparación y optimización del modelo
Formatos de exportación de modelos
PyTorch admite principalmente los siguientes formatos de exportación:
| Formato | Características | Casos de uso |
|---|---|---|
| TorchScript | Formato nativo de PyTorch, conserva las características del grafo dinámico | Uso interno en el ecosistema PyTorch |
| ONNX | Estándar abierto, compatible entre frameworks | Entorno de colaboración entre múltiples frameworks |
| Torch-TensorRT | Formato optimizado por NVIDIA | Aceleración de inferencia en GPU |
Exportar como TorchScript
Ejemplo
import torchvision
# Cargar el modelo preentrenado
model = torchvision.models.resnet18(pretrained=True)
model.eval()
# Entrada de ejemplo
example_input = torch.rand(1, 3, 224, 224)
# Método 1: exportar mediante tracing (seguimiento)
traced_script = torch.jit.trace(model, example_input)
traced_script.save("resnet18_traced.pt")
# Método 2: exportar mediante scripting (scripting)
scripted_model = torch.jit.script(model)
scripted_model.save("resnet18_scripted.pt")
Notas:
torch.jit.traceMás adecuado para modelos sin flujo de controltorch.jit.scriptPuede manejar modelos que contienen lógica compleja, como condicionales- Antes de exportar, asegúrate de llamar a
model.eval()
Elección de la estrategia de despliegue
Despliegue local
LibTorch (C++ API)
Ejemplo
int main() {
// Cargar el modelo
torch::jit::script::Module module;
module = torch::jit::load("resnet18.pt");
// Preparar la entrada
std::vector<torch::jit::IValue> inputs;
inputs.push_back(torch::ones({1, 3, 224, 224}));
// Ejecutar la inferencia
auto output = module.forward(inputs).toTensor();
std::cout << output.slice(/*dim=*/1, /*start=*/0, /*end=*/5) << '\n';
}
ONNX Runtime
Ejemplo
# Crear la sesión de inferencia
sess = ort.InferenceSession("model.onnx")
# Preparar la entrada
input_name = sess.get_inputs()[0].name
input_data = np.random.rand(1, 3, 224, 224).astype(np.float32)
# Ejecutar la inferencia
outputs = sess.run(None, {input_name: input_data})
Despliegue en la nube
TorchServe (marco de servicio oficial)
Ejemplo
pip install torchserve torch-model-archiver
# Empaquetar el modelo
torch-model-archiver --model-name resnet18 \
--version 1.0 \
--serialized-file model.pth \
--extra-files index_to_name.json \
--handler image_classifier \
--export-path model_store
# Iniciar el servicio
torchserve --start --model-store model_store --models resnet18=resnet18.mar
Construir una API REST con FastAPI
Ejemplo
from PIL import Image
import io
import torch
app = FastAPI()
model = torch.jit.load("model.pt")
@app.post("/predict")
async def predict(image: UploadFile = File(...)):
img_data = await image.read()
img = Image.open(io.BytesIO(img_data))
# Preprocesamiento...
with torch.no_grad():
output = model(img_tensor)
return {"prediction": output.argmax().item()}
Técnicas de optimización del rendimiento
Aceleración mediante cuantización
Ejemplo
quantized_model = torch.quantization.quantize_dynamic(
model, {torch.nn.Linear}, dtype=torch.qint8)
# Cuantización estática
model.qconfig = torch.quantization.get_default_qconfig('fbgemm')
torch.quantization.prepare(model, inplace=True)
# Calibración...
torch.quantization.convert(model, inplace=True)
Aceleración con TensorRT
Ejemplo
# Optimización de compilación
trt_model = torch_tensorrt.compile(model,
inputs=[torch_tensorrt.Input((1, 3, 224, 224))],
enabled_precisions={torch.float32} # o {torch.float16}
)
# Guardar el modelo optimizado
torch.jit.save(trt_model, "model_trt.pt")
Preguntas frecuentes
P1: ¿Qué hacer si surgen problemas de compatibilidad de versiones durante el despliegue?R: Se recomienda usar contenedores Docker para fijar las versiones del entorno, o mediantecondacrear un entorno dedicado.
P2: ¿Cómo monitorear el rendimiento del modelo desplegado?R: Se pueden integrar herramientas de monitoreo como Prometheus para rastrear la latencia, el rendimiento y el uso de recursos.
P3: ¿Cómo implementar actualizaciones en caliente después del despliegue del modelo?R: TorchServe admite la gestión de versiones de modelos y pruebas A/B; se pueden cambiar dinámicamente las versiones del modelo mediante API.
Otras extensiones