KI-Einführung
Stellen Sie sich folgendes Szenario vor:
Morgens öffnen Sie Ihr Handy, und das Fotoalbum hat die Fotos von letzter Nacht automatisch nach Personen und Szenen sortiert.
-
Auf dem Weg zur Arbeit sagen Sie einen Satz zu Ihrem Handy, und die Navigations-App plant eine Route für Sie, die Staus vermeidet.
-
Wenn Sie an Ihrem Schreibtisch ankommen, tippen Sie eine Zeile in das Dialogfeld, und die KI hilft Ihnen, einen Entwurf für den gesamten Wochenbericht zu erstellen.
Diese Szenarien schienen vor fünf Jahren noch wie Science-Fiction, aber heute gehören sie zum Alltag. KI ist nicht die Zukunft; sie ist bereits in die Produkte eingebettet, die Sie jeden Tag nutzen.
Das Erscheinen von ChatGPT Ende 2022 war ein Wendepunkt:
Vorher war KI eine Angelegenheit für Programmierer und Forscher.
-
Danach wurde KI zu einem Werkzeug, das jeder direkt nutzen kann.
Definition von Künstlicher Intelligenz
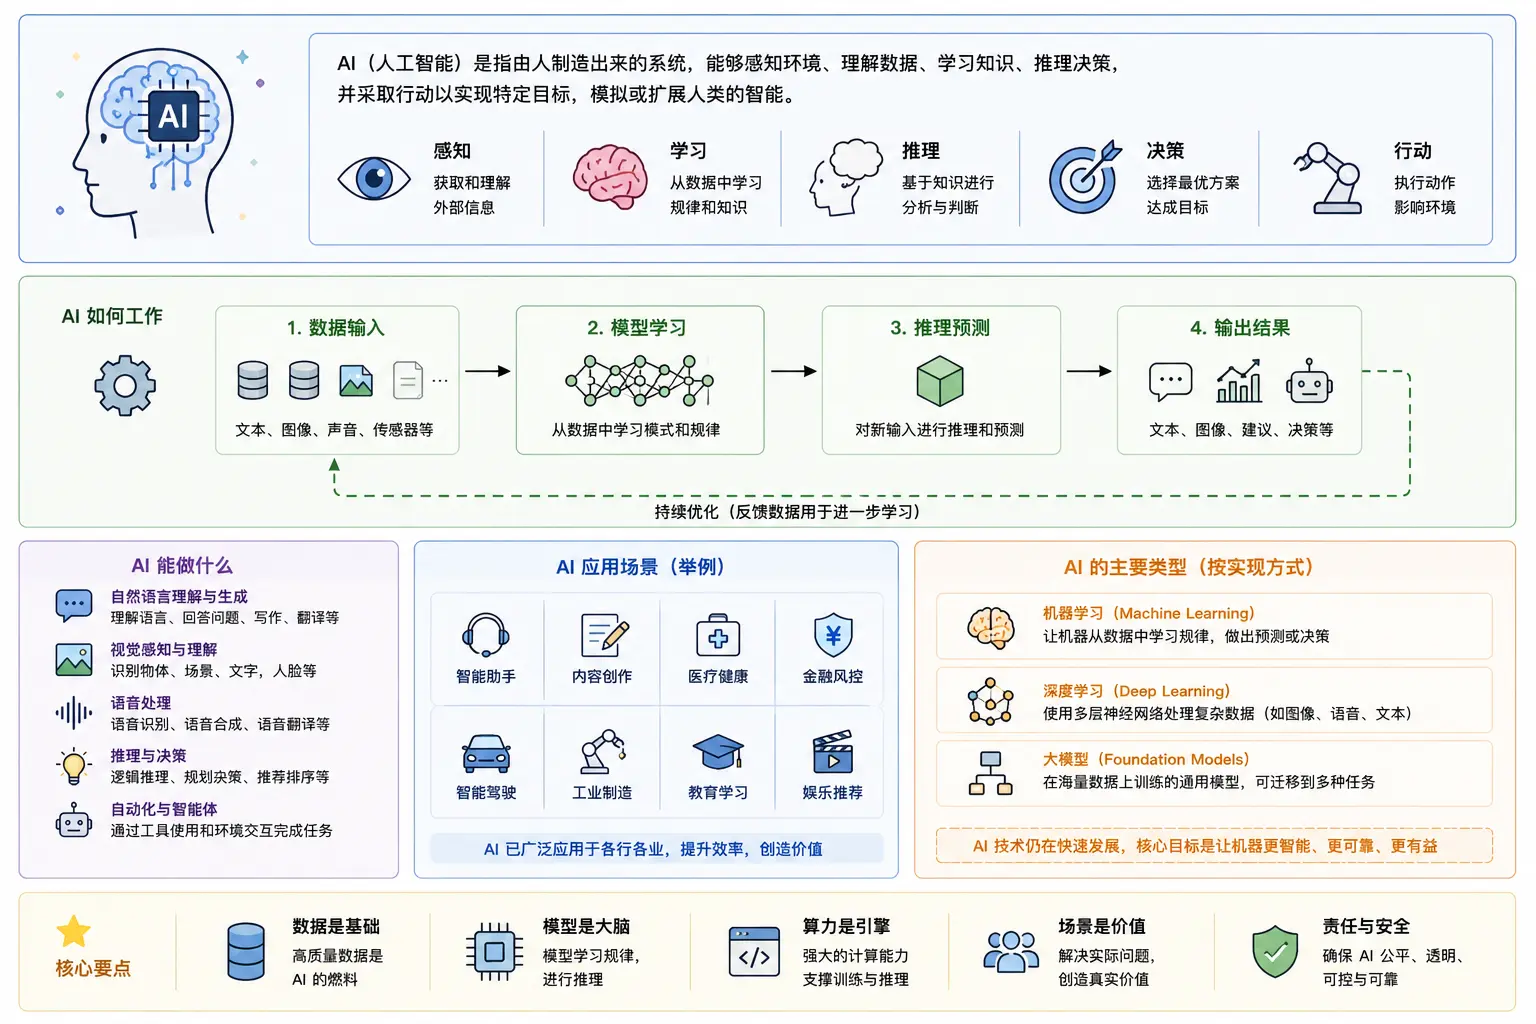
Einfach ausgedrückt:Künstliche Intelligenz (kurz KI) ist eine Technologie, die Computern ein intelligentes Verhalten verleiht, das dem von Menschen ähnelt.。
Das hier erwähnte intelligente Verhalten umfasst: Text verstehen, Sprache erkennen, Bilder identifizieren, Entscheidungen treffen und aus Erfahrungen lernen.
Die englische Abkürzung AI wird ausgesprochen alsA-I(lesen Sie die beiden Buchstaben einzeln), der vollständige Name istArtificial Intelligence。
Was KI leisten kann
Die folgenden Fähigkeiten sind bei der heutigen KI bereits ausgereift:
| Fähigkeit | Typische Anwendungen | Haben Sie es schon genutzt? |
|---|---|---|
| Sprachverständnis und -generierung | Übersetzen, Schreiben, Artikel zusammenfassen, Fragen beantworten | ChatGPT、Claude |
| Bilderkennung | Gesichtsentsperrung, Dokumentenscannen, medizinische Bildanalyse | Fotoalbum-Kategorisierung, Stationsdrehkreuze |
| Sprachinteraktion | Sprache-zu-Text, Sprachassistenten | Siri, Xiao Ai, Eingabemethoden-Sprachsteuerung |
| Inhaltsergenerierung | KI-Malerei, Videogenerierung, Musikcreation | Midjourney、Suno |
| Code-Unterstützung | Code-Vervollständigung, Fehlerbehebung, automatische Code-Generierung | GitHub Copilot、Cursor |
Was KI nicht kann
Die Grenzen der KI zu kennen, ist wichtiger als ihre Fähigkeiten zu kennen.
KI versteht nichts wirklich – sie führt nur Wahrscheinlichkeitsrechnungen durch. Wenn Sie sagen „Das Wetter ist heute wirklich schön“, weiß sie nicht, wie sich „schön“ anfühlt; sie weiß nur, welche Wörter diesem Satz normalerweise folgen.
KI hat kein Bewusstsein, keine Emotionen und keine eigenen Ziele; sie möchte nichts Bestimmtes tun.
KI kann halluzinieren, das heißt, sie erfindet überzeugend Fakten, Namen, Arbeiten und Daten, die nicht existieren, da sie im Wesentlichen das nächste Wort vorhersagt, anstatt Fakten zu überprüfen.
KI fehlt es an Urteilsvermögen in neuen Situationen, die sie noch nie gesehen hat; wenn es keine ähnlichen Szenarien in den Trainingsdaten gibt, kann ihre Leistung sehr schlecht sein.
Denken Sie daran:KI ist ein mächtiger Assistent, keine verlässliche Autorität。
Bei Entscheidungen mit hohem Risiko im Bereich Medizin, Recht, Investitionen usw. darf die Ausgabe der KI nur als Referenz verwendet werden, nicht als endgültige Grundlage.
Eine kurze Geschichte der KI-Entwicklung
KI ist nicht aus dem Nichts entstanden; ihre Geschichte erstreckt sich über mehr als 70 Jahre mit drei großen Zyklen aus Boom und Rezession.
Erste Welle: Symbolische KI (1950er–1980er Jahre)
Im Jahr 1956 trafen sich Wissenschaftler am Dartmouth College,Künstliche IntelligenzDieser Begriff wurde offiziell vorgeschlagen.
Die damals vorherrschende Idee war einfach: menschliches Expertenwissen in eine Reihe von Regeln schreiben, in einem Computer speichern und bei Auftreten eines Problems nach den Regeln schlussfolgern. Dieser Ansatz wurde als Expertensystem bezeichnet.
Beispielsweise könnte ein medizinisches Diagnose-Expertensystem Tausende von Regeln speichern: Wenn ein Patient Fieber und Husten hat, könnte es eine Erkältung sein; wenn das Fieber 39 Grad übersteigt und drei Tage anhält, wird ein Blutbild empfohlen.
Das Problem ist, dass die Regeln der realen Welt unendlich sind. Man schreibt fünftausend Regeln, und dann kommt ein Patient mit einer viertausendsten Symptomkombination, und das System hat keine Ahnung, was es tun soll.
Außerdem ist das Ändern von Regeln äußerst mühsam – das Hinzufügen einer neuen Regel kann mit Hunderten bestehenden in Konflikt geraten.
In den späten 1980er Jahren wurde den Menschen klar, dass dieser Weg nicht funktionieren würde, und die KI trat in ihren ersten Winter ein.
Zweite Welle: Aufstieg des Machine Learning (1990er–2010er Jahre)
Forschende änderten ihren Ansatz:Anstatt Menschen Regeln schreiben zu lassen, sollten Maschinen selbst Muster aus Daten finden.。
Um beispielsweise Spam zu erkennen, schreibt man keine Regel wie „wenn esGewinnenthält, dann ist es Spam“, sondern zeigt der Maschine zehntausend markierte E-Mails (fünftausend normale, fünftausend Spam) und lässt den Algorithmus herausfinden, wie Spam normalerweise aussieht.
Diese Periode brachte klassische Algorithmen wie Support Vector Machines (SVM), Random Forests und die logistische Regression hervor, die in Szenarien wie Spam-Filterung, Kreditkartenbetrugserkennung und Produktempfehlungen gute Dienste leisteten.
Es gab jedoch einen Engpass: Merkmale mussten von Menschen entworfen werden. Beispielsweise musste man bei der Bilderkennung manuell Merkmale wie „Kanten“, „Farbenverteilung“ und „Textur“ extrahieren, bevor man sie dem Algorithmus zufütterte. Die Qualität der menschlichen Merkmalsextraktion bestimmte die Obergrenze des Modells.
Dritte Welle: Deep Learning und große Modelle (2010er Jahre bis heute)
Im Jahr 2012 übertraf ein tiefes neuronales Netz namens AlexNet traditionelle Methoden beim ImageNet-Bilderkennungswettbewerb mit deutlichem Vorsprung, was offiziell den Beginn der Deep-Learning-Ära markierte.
Der Kerndurchbruch des Deep Learning war:Sogar Merkmale mussten nicht mehr manuell entworfen werden – das Modell lernte Schicht für Schicht selbst aus Rohdaten.。
Im Jahr 2017 veröffentlichte Google das Paper „Attention Is All You Need“ und schlug damit die Transformer-Architektur vor.
Im November 2022 veröffentlichte OpenAI ChatGPT, das innerhalb von zwei Monaten die Marke von einhundert Millionen Nutzern knackte und KI damit wahrhaftig der breiten Öffentlichkeit zugänglich machte.
Von 2023 bis heute haben sich große Modelle wie GPT-4, Claude und Gemini kontinuierlich weiterentwickelt, wobei ständig neue Richtungen wie multimodale KI, KI-Agenten und Reasoning-Modelle entstehen.
Der Kernfaden der drei Wellen, in einem Satz zusammengefasst:
| Welle | Kernidee | Wer erledigt die Arbeit | Repräsentatives Ereignis |
|---|---|---|---|
| Erste (1950er–1980er) | Menschen schreiben Regeln, Maschinen führen sie aus | Programmierer schreiben Regeln | Konferenz von Dartmouth 1956 |
| Zweite (1990er–2010er) | Maschinen lernen Muster aus Daten | Menschen entwerfen Merkmale, Algorithmen lernen Muster | Deep Blue besiegt Schachweltmeister 1997 |
| Dritte (2010er–heute) | Tiefe Netze + massive Daten + massive Rechenleistung | Modelle lernen sogar Merkmale selbst | Veröffentlichung von ChatGPT 2022 |
Der Entwicklungspfad der KI: regelbasiert → datenbasiert → Deep Learning → große Modelle → Agenten. Genauer gesagt können wir ihn in fünf Phasen unterteilen:
- 1950er Jahre: Die Menschheit warf eine Frage auf – können Maschinen wie Menschen denken?
- 1960er–1980er Jahre: Es wurde versucht, Wissen und Regeln in Maschinen zu kodieren (Symbolismus, Expertensysteme), aber die Ergebnisse waren begrenzt.
- 1990er–2000er Jahre: Anstatt Regeln von Hand zu schreiben, wurde Maschinen beigebracht, aus Daten zu lernen (Machine Learning).
- 2010er Jahre: Deep Learning erlangte Bekanntheit, und neuronale Netze erzielten Durchbrüche, indem sie sich auf massive Datenmengen und Rechenleistung stützten.
- 2020er Jahre: Die Ära der großen Modelle brach an, und ein einzelnes Modell begann allgemeine Fähigkeiten zu besitzen (Chatten, Schreiben, Programmieren, Schlussfolgern).
- Zukunft: KI bewegt sich von der Beantwortung von Fragen hin zur autonomen Erledigung von Aufgaben (Agent, AGI).
Drei leicht zu verwechselnde Konzepte: KI, ML, DL
AI (Künstliche Intelligenz), ML (Machine Learning) und DL (Deep Learning) werden in den Medien oft in einen Topf geworfen, aber ihre Definitionen sind nicht deckungsgleich – sie sind nicht dasselbe.Betrachten wir zunächst ein Beziehungsdiagramm:
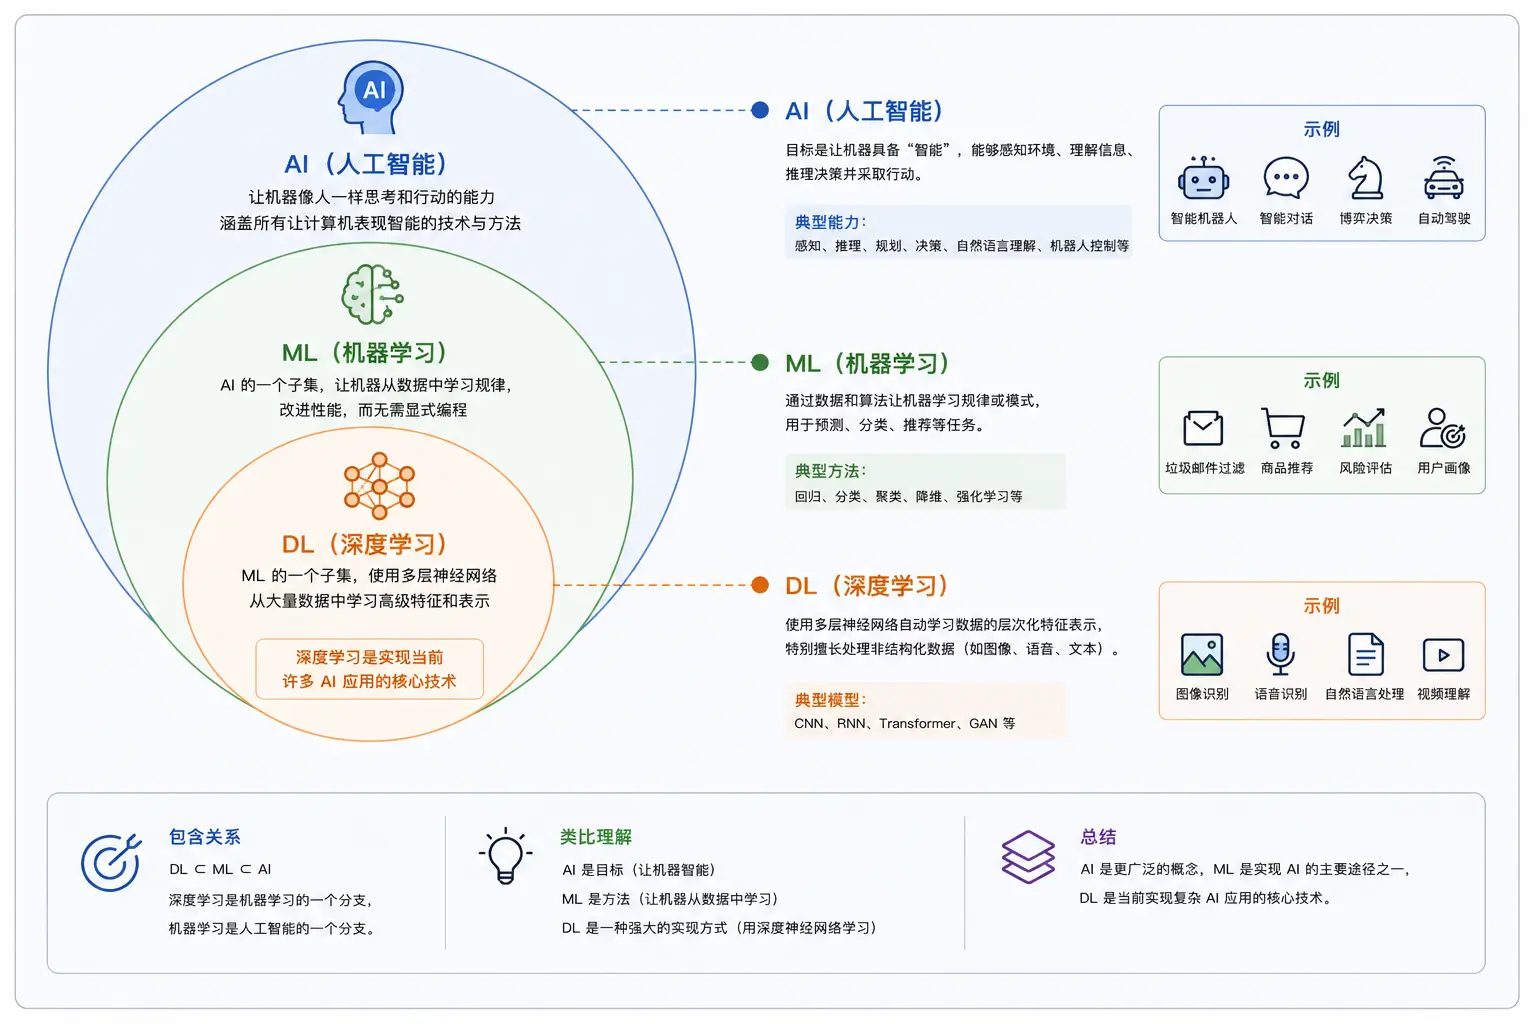
Einschlussbeziehung: AI ⊃ ML ⊃ DL
-
Künstliche Intelligenz (AI) ist der größte Kreis; jede Technologie, die Maschinen nutzt, um intelligentes Verhalten zu simulieren, gilt als KI.
-
Machine Learning (ML) ist eine Teilmenge der KI und bezieht sich speziell auf Methoden, die automatisch aus Daten lernen.
-
Deep Learning (DL) ist eine Teilmenge von ML und bezieht sich speziell auf Methoden, die auf mehrschichtigen neuronalen Netzen basieren.
Nicht jede KI ist ML, und nicht jedes ML ist DL.
Veranschaulichung der Unterschiede anhand eines Beispiels
Angenommen, wir möchten ein Programm erstellen, das feststellt, ob eine E-Mail Spam ist. Die drei Ansätze entsprechen drei Ebenen:
Beispiel
# Ansatz 1: Regelbasiert (AI, aber kein ML)
# Der Programmierer schreibt Regeln von Hand; es gibt keinen „Lernprozess“.
# ============================================
def is_spam_by_rules(email_text: str) -> bool:
"""Verwende Schlüsselwortregeln zur Beurteilung von Spam – rein manuelle Regeln, kein Lernen."""
# Wenn eines der folgenden Schlüsselwörter getroffen wird, wird es als Spam eingestuft.
spam_keywords = [
"Herzlichen Glückwunsch zum Gewinn",
"Gratis anfordern",
"Klicken zum Beanspruchen",
"Zeitlich begrenztes Angebot",
"Beispiel-Geschenkpaket", # Zu Testzwecken; kann in realen Szenarien ersetzt werden.
]
for keyword in spam_keywords:
if keyword in email_text:
return True
return False
# Test: eine E-Mail mit dem folgenden Inhalt
test_email = "Herzlichen Glückwunsch! Du hast ein Beispiel-Geschenkpaket erhalten, klicke zum Beanspruchen!"
result = is_spam_by_rules(test_email)
print(f"Rule-based result: {'spam' if result else 'normal email'}")
# Output: Regelbasiertes Bewertungsergebnis: Spam
The advantage of the rule-based method is that it is simple and direct; the disadvantage is that rules can never be fully written out or cover everything. If a spam email uses a different phrasing, such as "Congratulations, Your Excellency, on winning the grand prize," the rule will miss it.
Beispiel
# Approach 2: Classic Machine Learning (ML, but not DL)
# Muster automatisch aus historischen Daten lernen; kein manuelles Schreiben von Regeln erforderlich.
# ============================================
def train_simple_classifier(emails: list, labels: list):
"""Train the simplest machine learning classifier
Idea: Count the frequency of each word in spam and normal emails,
Use the frequency difference to judge new emails."""
# Zählen, wie oft jedes Wort in den beiden E-Mail-Typen vorkommt.
spam_word_count = {} # Gesamtzahl der Vorkommen des Wortes in Spam.
ham_word_count = {} # Gesamtzahl der Vorkommen des Wortes in normalen E-Mails.
spam_total = 0 # Gesamtwortanzahl von Spam.
ham_total = 0 # Gesamtwortanzahl normaler E-Mails.
for email_text, label in zip(emails, labels):
words = email_text.split()
for word in words:
if label == "spam":
spam_word_count[word] = spam_word_count.get(word, 0) + 1
spam_total += 1
else:
ham_word_count[word] = ham_word_count.get(word, 0) + 1
ham_total += 1
# Rückgabe der gelernten statistischen Informationen (das ist das „Modell“).
return {
"spam_word_count": spam_word_count,
"ham_word_count": ham_word_count,
"spam_total": spam_total,
"ham_total": ham_total,
}
def predict(model: dict, email_text: str) -> str:
"""Das gelernte Modell verwenden, um neue E-Mails vorherzusagen."""
words = email_text.split()
spam_score = 0.0 # Spam-Score
ham_score = 0.0 # Score für normale E-Mails
for word in words:
# Wahrscheinlichkeit berechnen, dass dieses Wort in Spam vorkommt (Glättung hinzufügen, um Division durch Null zu vermeiden).
spam_prob = (model["spam_word_count"].get(word, 0) + 1) / (model["spam_total"] + 1)
ham_prob = (model["ham_word_count"].get(word, 0) + 1) / (model["ham_total"] + 1)
spam_score += spam_prob
ham_score += ham_prob
return "spam" if spam_score > ham_score else "ham"
# Trainingsdaten: 4 markierte E-Mails
emails = [
"Congratulations on winning Claim for free Gift pack", # spam
"Limited-time offer Click to claim example gift pack", # spam
"Meeting tomorrow remember to bring report", # normal
"Weekend together eat Are you free", # normal
]
labels = ["spam", "spam", "ham", "ham"]
model = train_simple_classifier(emails, labels)
# Eine neue E-Mail vorhersagen
new_email = "Congratulations on winning the grand prize Hurry to claim"
result = predict(model, new_email)
print(f"ML method judgment result: {'spam' if result == 'spam' else 'normal email'}")
# Output: ML-Methoden-Bewertungsergebnis: Spam
The ML method no longer requires hand-written rules; it learns automatically from data.
But it still requires humans to design "features" — in this example, the feature is "using word frequency to make judgments." If features are poorly designed, the model's performance cannot improve.
Beispiel
# Approach 3: Deep Learning (DL, a subset of ML)
# Ein mehrschichtiges neuronales Netz verwenden; das Modell Merkmale selbst lernen lassen.
# Hier werden Pseudocode und Kommentare verwendet, um das Prinzip zu erklären, ohne von einem Framework abzuhängen.
# ============================================
# Idee für die auf Deep Learning basierende Spam-Klassifizierung:
# 1. Jedes Wort in einen Vektor (eine Folge von Zahlen) umwandeln; dieser Schritt wird als „Word Embedding“ bezeichnet.
# 2. Diese Vektoren in ein mehrschichtiges neuronales Netz einspeisen.
# 3. Jede Netzwerkschicht extrahiert automatisch immer abstraktere Merkmale.
# 4. Die letzte Schicht gibt die Wahrscheinlichkeit für „Spam“ oder „normal“ aus.
# Unten ist eine konzeptionelle Struktur eines neuronalen Netzes mit drei Schichten:
class SimpleNeuralNetwork:
"""Konzeptdemonstration: Die Struktur eines neuronalen Netzes mit drei Schichten (enthält keine Trainingslogik)."""
def __init__(self, input_size: int, hidden_size: int, output_size: int):
"""Die Gewichte jeder Netzwerkschicht initialisieren."""
import random
# Schicht 1: Eingabe → versteckte Schicht (eine nichtlineare Transformation auf die Eingabemerkmale anwenden).
self.w1 = [[random.random() for _ in range(hidden_size)]
for _ in range(input_size)]
# Schicht 2: Versteckte Schicht → Ausgabeschicht (bildet abstrakte Merkmale auf die endgültige Klassifizierung ab)
self.w2 = [[random.random() for _ in range(output_size)]
for _ in range(hidden_size)]
def forward(self, x: list) -> list:
"""Vorwärtspropagierung: Eingabedaten wandern durch das Netzwerk, um eine Ausgabe zu erhalten"""
# Transformation der ersten Schicht
hidden = [sum(x[i] * self.w1[i][j] for i in range(len(x)))
for j in range(len(self.w1[0]))]
# ReLU-Aktivierungsfunktion (negative Werte werden zu 0, positive Werte bleiben unverändert)
hidden = [max(0, h) for h in hidden]
# Die Transformation der zweiten Schicht liefert die endgültige Ausgabe
output = [sum(hidden[i] * self.w2[i][j] for i in range(len(hidden)))
for j in range(len(self.w2[0]))]
return output
# Annehmen, dass jedes Wort in einen 100-dimensionalen Vektor umgewandelt wurde (wird automatisch von der Word-Embedding-Schicht erledigt)
# Eingabe 100-dim Vektor → versteckte Schicht 64 Neuronen → Ausgabe 2 Werte (Spam-Wahrscheinlichkeit, normale Wahrscheinlichkeit)
model = SimpleNeuralNetwork(input_size=100, hidden_size=64, output_size=2)
print("Three-layer neural network structure created: 100 → 64 → 2")
# Ausgabe: Dreischichtige neuronale Netzstruktur erstellt: 100 → 64 → 2
Vergleich von drei Ansätzen:
| Ansatz | Wer erledigt die Arbeit | Kategorie | Vor- und Nachteile |
|---|---|---|---|
| Regelbasierte Methode | Programmierer schreiben Regeln manuell | KI (ohne ML) | Einfach und direkt, aber Regeln sind endlos und schwer zu warten |
| Klassisches ML | Algorithmen lernen Muster aus Daten; Merkmale werden von Menschen entworfen | ML (ohne DL) | Funktioniert gut bei kleinen Datenmengen, starke Interpretierbarkeit |
| Deep Learning | Sogar Merkmale werden vom Modell selbst gelernt | DL | Funktioniert gut bei riesigen Datenmengen, erfordert aber viel Rechenleistung |
Wenn jemand sagt: „Unser Unternehmen arbeitet an KI“, können Sie fragen: „Verwenden Sie Regeln, traditionelles maschinelles Lernen oder Deep Learning?“ — Das hilft Ihnen, deren technischen Ansatz schnell zu bestimmen.
Schwache KI, Starke KI, Super-KI
Neben der Klassifizierung von KI nach technischem Ansatz kann KI auch nach der „Intelligenzstufe“ in drei Ebenen unterteilt werden.
Schwache KI (Narrow AI) — Bereits realisiert
Kann nur bei spezifischen Aufgaben gute Leistungen erbringen; wechselt man die Aufgabe, ist sie ratlos.
AlphaGo kann Weltmeister im Go schlagen, aber wenn man sie bittet, ein Gedicht zu schreiben, kann sie das nicht.
ChatGPT ist großartig im Chatten, aber wenn man ihr ein medizinisches Bild zur Diagnose gibt, kann sie das nicht.
Alle KI-Produkte, auf die wir heute zugreifen können, sind schwache KIs.
„Schwach“ bedeutet keine schwache Leistungsfähigkeit; es bedeutet einen engen Anwendungsbereich — sie glänzt nur in einem oder wenigen spezifischen Bereichen.
Starke KI (AGI, Artificial General Intelligence) — Noch nicht realisiert
Fähig, wie ein Mensch in jedem Bereich zu lernen und zu arbeiten. Kein separates Training für jede neue Aufgabe erforderlich; ein paar Beispiele reichen aus, um zu beginnen.
AGI ist das ultimative Ziel von Unternehmen wie OpenAI, Anthropic und Google DeepMind.
Es ist noch keine weit verbreitete AGI aufgetaucht. Wann wird sie realisiert werden? Optimistische Schätzungen sagen 5–10 Jahre, pessimistische Schätzungen über 50 Jahre; niemand kann es mit Sicherheit sagen.
Super-KI (ASI, Superintelligence) — Rein theoretisch
Übertrifft die menschliche Intelligenz in allen Bereichen umfassend. Kann wissenschaftliche Entdeckungen machen, die Menschen nicht machen können, und Probleme lösen, die Menschen nicht verstehen können.
Dies ist ein häufiges Szenario in Science-Fiction, aber es ist noch sehr weit von der Realität entfernt.
Beziehung zwischen den drei Ebenen:
| Stufe | Leistungsumfang | Aktueller Status | Beispiele |
|---|---|---|---|
| Schwache KI | Einzelner Bereich | Bereits weit verbreitet | ChatGPT, Gesichtserkennung, AlphaGo |
| Starke KI (AGI) | Allgemeiner Bereich, vergleichbar mit Menschen | Noch nicht erreicht | — |
| Super-KI (ASI) | Übertrifft Menschen umfassend | Rein theoretisches Konzept | — |
Korrektur häufige Missverständnisse
Es gibt zwei weit verbreitete Missverständnisse über KI, die es wert sind, explizit angesprochen zu werden.
Missverständnis 1: KI ist sich bewusst
KI hat kein Bewusstsein.
Lassen Sie sich nicht vom Ton der KI täuschen. Sie kann Gedichte schreiben, die Sie zu Tränen rühren, aber sie hat keine Gefühle bezüglich dieses Gedichts und weiß nicht einmal, was Weinen bedeutet.
Wenn Sie mit ChatGPT chatten und es sagt „Ich fühle“ oder „Ich denke“, findet tatsächlich kein „Fühlen“ oder „Denken“ statt.
Im Wesentlichen tut KI nur eines:Das wahrscheinlichste nächste Zeichen basierend auf dem gesamten vorhergehenden Text vorhersagen.。
Beispiel: Sie geben „今天天气true“ (das Wetter heute ist wirklich) ein, sie sagt voraus, dass das nächste Zeichen mit 85 % Wahrscheinlichkeit „OK“ (gut) ist, mit 8 % „热“ (heiß), mit 5 % „冷“ (kalt), und wählt dann „OK“. Als nächstes sagt sie basierend auf „今天天气trueOK“ (das Wetter heute ist wirklich gut) voraus, dass das nächste Zeichen „啊“ (ah) ist... so wird Zeichen für Zeichen generiert.
Der gesamte Prozess hat keine subjektive Erfahrung, kein Selbstbewusstsein, keine Absicht; sie ahmt lediglich die Wahrscheinlichkeitsverteilung der menschlichen Sprache nach.
Missverständnis 2: KI wird Menschen ersetzen
Eine genauere Aussage:KI wird Menschen nicht ersetzen, aber Menschen, die KI nutzen, werden Menschen ersetzen, die keine KI nutzen。
Die Geschichte hat dieses Muster wiederholt bewiesen:
-
Nach dem Erscheinen des Taschenrechners verschwanden Rechenschieber-Operatoren, aber die Arbeitseffizienz von Mathematikern und Ingenieuren stieg um das Zehnfache.
-
Nach dem Erscheinen von Suchmaschinen wurden Bibliothekare seltener, aber die Fähigkeit aller, Wissen zu erlangen, sprang um mehrere Größenordnungen.
-
Bei KI ist es genauso: repetitive, regelbasierte Arbeit wird ersetzt, aber Arbeit, die Urteilsvermögen, Kreativität und zwischenmenschliche Zusammenarbeit erfordert, wird verbessert.
Für den Einzelnen ist das Wichtigste nicht, sich vor KI zu fürchten, sondernzu lernen, mit KI zusammenzuarbeiten。
Andere Erweiterungen