1. Qu'est-ce que REST

REST est l'acronyme de Representational State Transfer, ce qui, en chinois, signifie transfert d'état représentationnel (note de l'éditeur : généralement traduit par représentationnel). Cette notion est apparue pour la première fois dans la thèse de doctorat de Roy Fielding en 2000. Roy Fielding est l'un des principaux auteurs de la spécification HTTP. Dans sa thèse, il mentionne : « Le but de la rédaction de cet article est de comprendre et d'évaluer la conception architecturale des logiciels applicatifs en réseau, sous l'hypothèse du respect des principes architecturaux, et d'obtenir une architecture aux fonctionnalités solides, aux bonnes performances et adaptée à la communication. REST désigne un ensemble de contraintes et de principes architecturaux. » Si une architecture respecte les contraintes et les principes de REST, nous l'appelons une architecture RESTful.
REST lui-même ne crée pas de nouvelles technologies, de nouveaux composants ou services. L'idée derrière RESTful est d'utiliser les fonctionnalités et capacités existantes du Web, et de mieux exploiter certaines des lignes directrices et contraintes des standards Web existants. Bien que REST lui-même soit profondément influencé par les technologies Web, théoriquement le style architectural REST n'est pas lié à HTTP ; cependant, HTTP est actuellement la seule instance liée à REST. Donc le REST que nous décrivons ici est aussi REST mis en œuvre via HTTP.
2. Comprendre RESTful
Pour comprendre l'architecture RESTful, nous devons comprendre ce que signifie réellement l'expression Representational State Transfer et ce que chacun de ses mots implique.
Ci-dessous, en combinant les principes REST, nous allons discuter autour des ressources. Du point de vue de la définition, de l'acquisition, de la représentation, de l'association et de la transition d'état des ressources, nous allons lister quelques concepts clés et les expliquer.
- Ressources et URI
- Interface uniforme des ressources
- Représentations des ressources
- Liens de ressources
- Transfert d'état
2.1 Ressources et URI
REST signifie Representational State Transfer. Mais qu'est-ce qui est exactement représenté ? En fait, il s'agit de ressources. Tout ce qui doit pouvoir être référencé est une ressource. Une ressource peut être une entité (par exemple, un numéro de téléphone mobile) ou simplement un concept abstrait (par exemple, une valeur). Voici quelques exemples de ressources :
- Le numéro de téléphone mobile d'un utilisateur
- Les informations personnelles d'un utilisateur
- Le forfait GPRS auquel la plupart des utilisateurs souscrivent
- Relation de dépendance entre deux produits
- Forfaits de réduction qu'un utilisateur peut demander
- La valeur potentielle d'un numéro de téléphone mobile
Pour rendre une ressource identifiable, un identifiant unique est nécessaire. Sur le Web, cet identifiant unique est l'URI (Uniform Resource Identifier).
Une URI peut être considérée comme soit l'adresse d'une ressource, soit le nom d'une ressource. Si une information n'est pas représentée par une URI, elle ne peut pas être considérée comme une ressource, mais seulement comme une information sur une ressource. La conception des URI doit suivre le principe d'adressabilité, être auto-descriptive et donner aux gens une association intuitive de par leur forme. Ici, en prenant le site GitHub comme exemple, quelques URI plutôt bonnes sont données :
- https://github.com/git
- https://github.com/git/git
- https://github.com/git/git/blob/master/block-sha1/sha1.h
- https://github.com/git/git/commit/e3af72cdafab5993d18fae056f87e1d675913d08
- https://github.com/git/git/pulls
- https://github.com/git/git/pulls?state=closed
- https://github.com/git/git/compare/master…next
Voyons maintenant quelques conseils pour la conception d'URI :
- Utilisez _ ou - pour rendre les URI plus lisibles
Auparavant, les URI sur le Web étaient toutes des nombres froids ou des chaînes sans signification, mais aujourd'hui de plus en plus de sites web utilisent _ ou - pour séparer les mots, ce qui rend les URI plus conviviales pour l'humain. Par exemple, la célèbre communauté open source chinoise (OSChina) utilise ce style pour les adresses de ses actualités, comme http://www.oschina.net/news/38119/oschina-translate-reward-plan.
- Utilisez / pour représenter la relation hiérarchique des ressources
Par exemple, l'URI ci-dessus /git/git/commit/e3af72cdafab5993d18fae056f87e1d675913d08 représente une ressource à plusieurs niveaux, faisant référence à un enregistrement de commit du projet git de l'utilisateur git. Autre exemple : /orders/2012/10 peut être utilisé pour représenter les enregistrements de commandes d'octobre 2012.
- Utilisez ? pour filtrer les ressources
Beaucoup de gens considèrent simplement ? comme un moyen de passer des paramètres, ce qui peut facilement rendre les URI trop complexes et difficiles à comprendre. Vous pouvez utiliser ? pour filtrer les ressources. Par exemple, /git/git/pulls représente toutes les pull requests du projet git, tandis que /pulls?state=closed représente les pull requests fermées du projet git. De telles URL correspondent généralement à des résultats de requête dans des conditions spécifiques ou à des résultats d'opérations d'algorithmes.
- , ou ; peuvent être utilisés pour représenter la relation entre des ressources de même niveau
Parfois, lorsque nous devons représenter la relation entre des ressources de même niveau, nous pouvons utiliser , ou ; pour les séparer. Par exemple, si GitHub pouvait comparer les différences d'un fichier entre deux enregistrements de commit, il pourrait peut-être utiliser /git/git /block-sha1/sha1.h/compare/e3af72cdafab5993d18fae056f87e1d675913d08;bd63e61bdf38e872d5215c07b264dcc16e4febca comme URI. Cependant, GitHub utilise actuellement ... pour ce faire, par exemple /git/git/compare/master...next.
2.2 Interface uniforme des ressources
Une architecture RESTful doit suivre le principe d'interface uniforme. L'interface uniforme contient un ensemble d'opérations restreintes et prédéfinies. Peu importe la ressource, elle est accessible via la même interface. L'interface doit utiliser les méthodes HTTP standard telles que GET, PUT et POST, et suivre la sémantique de ces méthodes.
Si les ressources sont exposées conformément à la sémantique des méthodes HTTP, l'interface aura les caractéristiques de sûreté et d'idempotence. Par exemple, les requêtes GET et HEAD sont sûres ; peu importe combien de fois elles sont demandées, l'état du serveur ne changera pas. Les requêtes GET, HEAD, PUT et DELETE sont idempotentes ; peu importe combien de fois la ressource est manipulée, le résultat est toujours le même, et les requêtes suivantes n'auront pas plus d'impact que la première.
Les utilisations typiques de GET, DELETE, PUT et POST sont listées ci-dessous :
GET
- Sûr et idempotent
- Récupérer une représentation
- Récupérer une représentation lors d'un changement (cache)
- 200 (OK) - Indique que la représentation a été envoyée dans la réponse
- 204 (No Content) - La ressource a une représentation vide
- 301 (Moved Permanently) - L'URI de la ressource a été mise à jour
- 303 (See Other) - Autre (par exemple, répartition de charge)
- 304 (Not Modified) - La ressource n'a pas été modifiée (cache)
- 400 (Bad Request) - Indique une requête incorrecte (par exemple, erreurs de paramètres)
- 404 (Not Found) - La ressource n'existe pas
- 406 (Not Acceptable) - Le serveur ne prend pas en charge la représentation requise
- 500 (Internal Server Error) - Réponse d'erreur générique
- 503 (Service Unavailable) - Le serveur ne peut pas traiter la requête pour le moment
POST
- Non sûr et non idempotent
- Créer des ressources à l'aide de numéros d'instance gérés par le serveur (générés automatiquement)
- Créer des ressources enfants
- Mettre à jour partiellement des ressources
- Si elle n'a pas été modifiée, ne mettez pas à jour la ressource (verrouillage optimiste)
- 200 (OK) - Si la ressource existante a été modifiée
- 201 (Created) - Si une nouvelle ressource a été créée
- 202 (Accepted) - La requête a été acceptée pour traitement mais n'a pas encore été terminée (traitement asynchrone)
- 301 (Moved Permanently) - L'URI de la ressource a été mise à jour
- 303 (See Other) - Autre (par exemple, répartition de charge)
- 400 (Bad Request) - Indique une mauvaise requête
- 404 (Not Found) - La ressource n'existe pas
- 406 (Not Acceptable) - Le serveur ne prend pas en charge la représentation requise
- 409 (Conflict) - Conflit générique
- 412 (Precondition Failed) - Échec de la précondition (par exemple, un conflit lors de l'exécution d'une mise à jour conditionnelle)
- 415 (Unsupported Media Type) - La représentation reçue n'est pas prise en charge
- 500 (Internal Server Error) - Réponse d'erreur générique
- 503 (Service Unavailable) - Le serveur ne peut pas traiter la requête pour le moment
PUT
- Non sûr mais idempotent
- Créer une ressource à l'aide d'un numéro d'instance géré par le client
- Mettre à jour une ressource en la remplaçant
- Si non modifiée, alors mettre à jour la ressource (verrou optimiste)
- 200 (OK) - si une ressource existante a été modifiée
- 201 (created) - si une nouvelle ressource a été créée
- 301 (Déplacé de façon permanente) - l'URI de la ressource a changé
- 303 (Voir autre) - autre (par ex., équilibrage de charge)
- 400 (requête incorrecte) - désigne une requête incorrecte
- 404 (non trouvé) - la ressource n'existe pas
- 406 (non acceptable) - le serveur ne prend pas en charge la représentation requise
- 409 (conflit) - conflit général
- 412 (Échec de la précondition) - échec de la précondition (par ex., conflit lors de l'exécution d'une mise à jour conditionnelle)
- 415 (type de média non pris en charge) - la représentation reçue n'est pas prise en charge
- 500 (erreur interne du serveur) - réponse d'erreur générale
- 503 (Service indisponible) - le service est actuellement incapable de traiter la requête
DELETE
- Non sûr mais idempotent
- Supprimer une ressource
- 200 (OK) - la ressource a été supprimée
- 301 (Déplacé de façon permanente) - l'URI de la ressource a changé
- 303 (Voir autre) - autre, par exemple, l'équilibrage de charge
- 400 (requête incorrecte) - désigne une requête incorrecte
- 404 (non trouvé) - la ressource n'existe pas
- 409 (conflit) - conflit général
- 500 (erreur interne du serveur) - réponse d'erreur générale
- 503 (Service indisponible) - le serveur est actuellement incapable de traiter la requête
Voyons maintenant quelques problèmes courants en pratique :
- Quelle est la différence entre POST et PUT lors de la création de ressources ?
La différence entre POST et PUT lors de la création de ressources réside dans le fait de savoir si le nom (URI) de la ressource créée est déterminé par le client. Par exemple, pour ajouter une catégorie java à mon billet de blog, le chemin généré serait nom de catégorie/categories/java, donc la méthode PUT peut être utilisée. Cependant, beaucoup de personnes associent directement POST, GET, PUT, DELETE à CRUD, comme cela se fait dans une application RESTful typique implémentée avec Rails.
Je pense que c'est parce que Rails utilise par défaut des IDs générés par le serveur comme URI, et que beaucoup de personnes pratiquent REST via Rails, ce qui peut facilement causer de tels malentendus.
- Les clients ne prennent pas nécessairement en charge toutes ces méthodes HTTP, n'est-ce pas ?
Il est vrai que cette situation existe, en particulier avec certains clients plus anciens basés sur navigateur qui ne prennent en charge que GET et POST.
En pratique, le client et le serveur peuvent tous deux devoir faire des compromis. Par exemple, le framework Rails prend en charge le passage de la véritable méthode de requête via un paramètre caché _method=DELETE, tandis que les frameworks MVC côté client comme Backbone permettent de passer _method et de définir l'en-tête X-HTTP-Method-Override pour contourner ce problème.
- L'interface uniforme signifie-t-elle que les méthodes ayant une sémantique spéciale ne peuvent pas être étendues ?
L'interface uniforme ne vous empêche pas d'étendre les méthodes, tant que les méthodes ont une sémantique spécifique et identifiable pour les opérations sur les ressources et peuvent maintenir l'uniformité de toute l'interface.
Par exemple, WebDAV étend les méthodes HTTP en ajoutant LOCK, UPLOCK et d'autres méthodes. L'API de GitHub prend également en charge la méthode PATCH pour mettre à jour des tickets, par exemple :
PATCH /repos/:owner/:repo/issues/:number
Cependant, notez que pour les méthodes HTTP non standard comme PATCH, le serveur doit examiner si les clients peuvent les prendre en charge.
- Quelles directives l’interface uniforme des ressources fournit-elle pour les URI ?
L’interface uniforme des ressources exige d’utiliser des méthodes HTTP standard pour opérer sur les ressources, donc les URI ne doivent représenter que les noms des ressources et ne doivent pas inclure d’opérations sur les ressources.
En termes simples, les URI ne doivent pas être décrites à l’aide d’actions. Par exemple, les URI suivantes ne répondent pas aux exigences de l’interface uniforme :
- GET /getUser/1
- POST /createUser
- PUT /updateUser/1
- DELETE /deleteUser/1
Si une requête GET incrémente un compteur, cela enfreint-il la sûreté ?
La sûreté ne signifie pas que la requête ne produit aucun effet de bord. Par exemple, de nombreuses plateformes de développement d’API limitent le trafic des requêtes. GitHub, par exemple, limite les requêtes non authentifiées à 60 requêtes par heure.
Mais les clients n’envoient pas ces requêtes GET ou HEAD dans le but de produire des effets de bord ; les effets de bord sont le fait du serveur.
De plus, le serveur ne doit pas rendre les effets de bord trop importants dans sa conception, car les clients supposent que ces requêtes ne produisent pas d’effets de bord.
- Est-il acceptable d’ignorer directement la mise en cache ?
Même si vous utilisez chaque verbe conformément à son intention d’origine, vous pouvez toujours facilement désactiver le mécanisme de mise en cache. La façon la plus simple est d’ajouter un en-tête dans votre réponse HTTP : Cache-control: no-cache. Toutefois, ce faisant, vous perdez aussi la prise en charge d’une mise en cache efficace et de la revalidation (à l’aide de mécanismes tels que Etag).
Pour les clients, lors de l’implémentation d’un client pour un service de style REST, vous devriez également tirer pleinement parti des mécanismes de mise en cache existants afin d’éviter de récupérer les représentations à chaque fois.
- Est-il nécessaire de gérer les codes de réponse ?
Les codes de réponse HTTP peuvent être utilisés pour gérer différentes situations. Utiliser correctement ces codes d’état signifie que les clients et les serveurs peuvent communiquer à un niveau avec une sémantique plus riche.
Par exemple, le code de réponse 201 ("Created") indique qu’une nouvelle ressource a été créée, et son URI se trouve dans l’en-tête de réponse Location.
Si vous ne tirez pas parti de la riche sémantique applicative des codes d’état HTTP, vous manquerez des occasions d’améliorer la réutilisabilité, de renforcer l’interopérabilité et d’accroître le découplage.
Si ces applications dites RESTful doivent fournir des informations d’erreur via les corps de réponse, alors SOAP est déjà comme cela et peut y satisfaire.
2.3 Représentations des ressources
Il a été mentionné plus haut que les clients peuvent obtenir des ressources via les méthodes HTTP, n’est-ce pas ? Non, pour être précis, ce que les clients obtiennent n’est que la représentation de la ressource. La présentation externe d’une ressource peut prendre de multiples formes de représentation, et ce qui est transmis entre le client et le serveur est aussi la représentation de la ressource, et non la ressource elle-même. Par exemple, les ressources textuelles peuvent utiliser des formats tels que html, xml et json, tandis que les images peuvent être affichées à l’aide de PNG ou JPG.
La représentation d’une ressource inclut les données et les métadonnées décrivant les données. Par exemple, l’en-tête HTTP "Content-Type" est un tel attribut de métadonnées.
Alors, comment le client sait-il quelle forme de représentation le serveur fournit ?
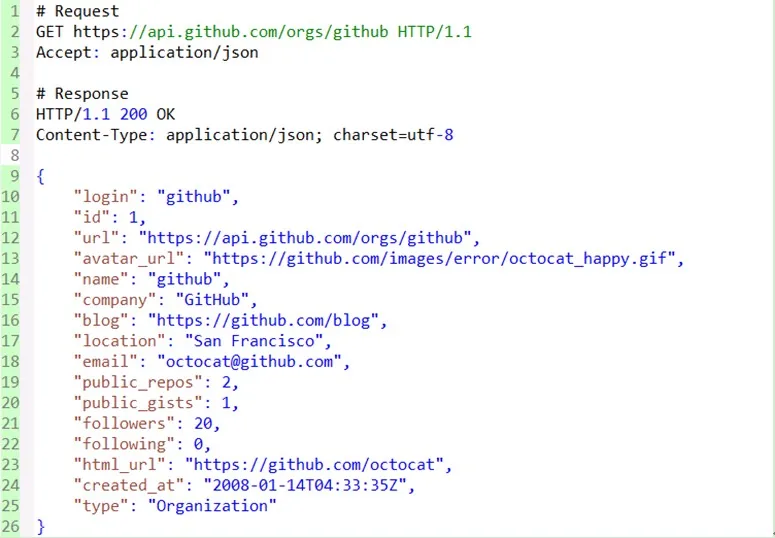
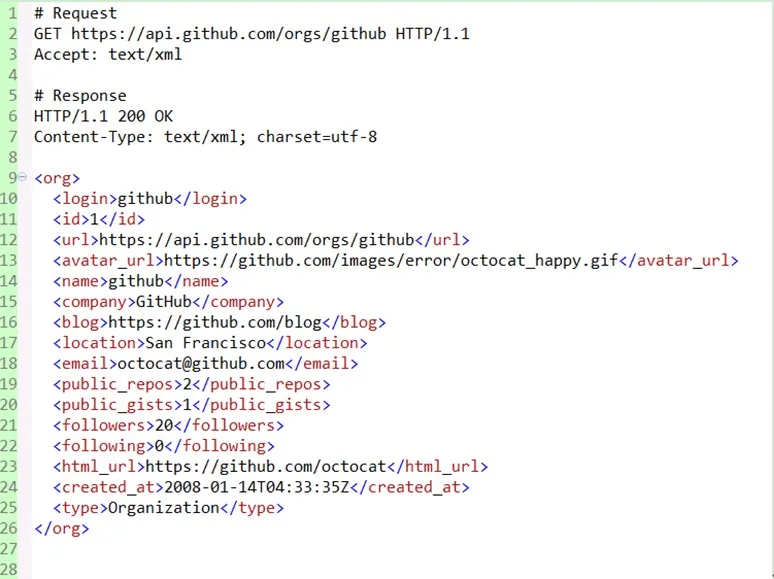
La réponse est via la négociation de contenu HTTP. Le client peut demander un format spécifique de représentation en utilisant l'en-tête Accept, et le serveur indique au client la forme de représentation de la ressource via Content-Type.
Prenons GitHub comme exemple, demandons la représentation json d'une ressource d'organisation :
Si GitHub pouvait aussi prendre en charge le format de représentation xml, le résultat ressemblerait à ceci :
Voyons maintenant quelques conceptions courantes en pratique :
Inclure les numéros de version dans l'URI
Certaines API incluent les numéros de version dans l'URI, par exemple :
- http://api.example.com/1.0/foo
- http://api.example.com/1.2/foo
- http://api.example.com/2.0/foo
Si nous comprenons le numéro de version comme une forme de représentation différente de la ressource, alors nous devrions utiliser une seule URL et la distinguer via l'en-tête Accept. Toujours en prenant GitHub comme exemple, son format Accept complet est : application/vnd.github[.version].param[+json]
Pour la version v3, ce serait Accept: application/vnd.github.v3. Pour l'exemple ci-dessus, vous pouvez de même utiliser l'en-tête suivant :
- Accept: vnd.example-com.foo+json; version=1.0
- Accept: vnd.example-com.foo+json; version=1.2
- Accept: vnd.example-com.foo+json; version=2.0
Utiliser des suffixes d'URI pour distinguer les formats de représentation
Le framework Rails, par exemple, prend en charge l'utilisation de /users.xml ou /users.json pour distinguer différents formats. Une telle approche est sans aucun doute plus intuitive pour les clients, mais elle mélange le nom de la ressource avec la forme de représentation de la ressource. Personnellement, je pense que la négociation de contenu devrait encore être privilégiée pour distinguer les formats de représentation.
Comment gérer les formats de représentation non pris en charge
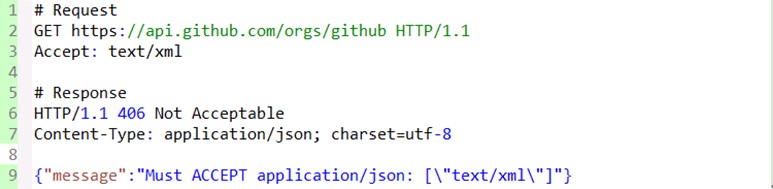
Que faut-il faire lorsque le serveur ne prend pas en charge le format de représentation demandé ? S'il ne le prend pas en charge, il doit renvoyer une réponse HTTP 406, indiquant qu'il refuse de traiter la requête. Prenons GitHub comme exemple, ci-dessous le résultat d'une demande de représentation XML d'une ressource :
2.4 Liens de ressource
Nous savons que REST utilise les méthodes HTTP standard pour manipuler les ressources, mais le comprendre simplement comme une architecture de base de données Web avec CRUD est trop simpliste.
Cet anti-pattern ignore un concept fondamental : « l'hypermédia comme moteur de l'état de l'application ». Qu'est-ce que l'hypermédia ?
Lorsque vous naviguez sur des pages web, en sautant d'un lien à une page, puis d'un autre lien à une autre page, vous utilisez le concept d'hypermédia : relier les ressources une par une.
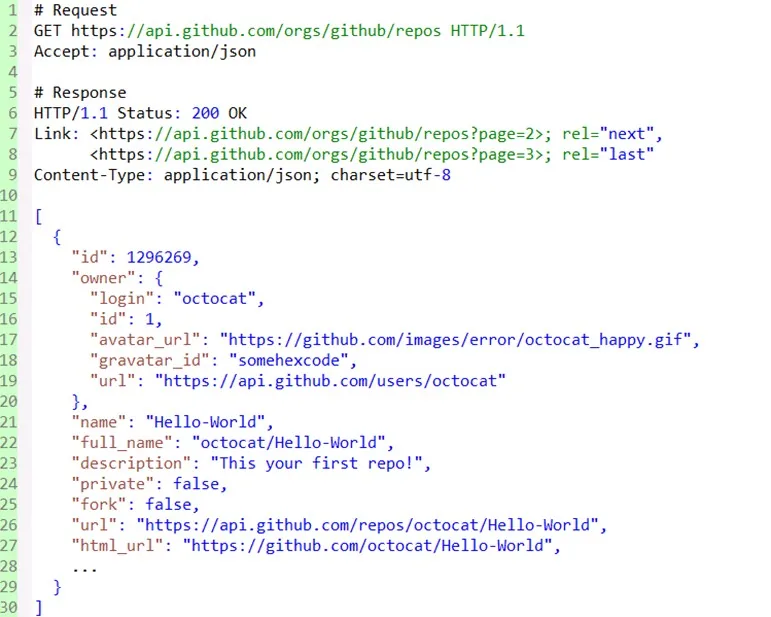
Pour y parvenir, des liens doivent être ajoutés aux formats de représentation afin de guider les clients. Dans le livre « RESTful Web Services », l'auteur appelle cette caractéristique consistant à avoir des liens la connectivité. Ci-dessous, examinons quelques exemples spécifiques.
Voici une requête à GitHub pour obtenir la liste des projets d'une organisation. Vous pouvez voir qu'un en-tête Link est ajouté dans l'en-tête de réponse pour indiquer au client comment accéder à la page suivante et à la dernière page d'enregistrements. Dans le corps de la réponse, des URL sont utilisées pour établir des liens vers le propriétaire du projet et l'adresse du projet.
Un autre exemple est celui ci-dessous : après la création d'une commande, des liens sont utilisés pour guider le client sur la façon d'effectuer le paiement.

Les exemples ci-dessus montrent comment utiliser l'hypermédia pour renforcer la connectivité des ressources. Beaucoup de personnes passent beaucoup de temps à chercher de belles URI lors de la conception d'architectures RESTful, mais ignorent l'hypermédia. Par conséquent, il faudrait consacrer plus de temps à fournir des liens dans les représentations des ressources, plutôt que de se concentrer sur le « CRUD des ressources ».
2.5 Transfert d'état
Avec les bases ci-dessus, il devient facile de comprendre le transfert d'état dans REST.
Cependant, commençons d'abord par discuter du principe de communication sans état dans REST. À première vue, cela semble contradictoire : puisque c'est sans état, comment peut-il y avoir un transfert d'état ?
En fait, le principe de communication sans état mentionné ici ne signifie pas que l'application cliente ne peut pas avoir d'état, mais plutôt que le serveur ne doit pas conserver l'état du client.
2.5.1 État d'application et état de ressource
En fait, il faut distinguer l'état d'application et l'état de ressource. Le client est responsable du maintien de l'état d'application, tandis que le serveur maintient l'état de ressource.
L'interaction entre le client et le serveur doit être sans état, et chaque requête doit contenir toutes les informations nécessaires pour traiter cette requête.
Le serveur n'a pas besoin de conserver l'état d'application entre les requêtes. Ce n'est que lorsqu'une requête réelle est reçue que le serveur prête attention à l'état d'application.
Ce principe de communication sans état permet au serveur et aux intermédiaires de comprendre des requêtes et des réponses indépendantes.
Sur plusieurs requêtes, le même client n'a plus besoin de dépendre du même serveur, ce qui facilite la mise en œuvre de serveurs hautement évolutifs et hautement disponibles.
Mais parfois, nous réalisons des conceptions qui enfreignent le principe de communication sans état, comme l'utilisation de cookies pour suivre un état de session côté serveur, un exemple courant étant JSESSIONID dans J2EE.
Cela signifie que les cookies envoyés par le navigateur à chaque requête sont utilisés pour construire l'état de session.
Bien sûr, si les cookies stockent des informations que le serveur peut vérifier sans s'appuyer sur l'état de session (comme un jeton d'authentification), de tels cookies sont également conformes aux principes REST.
2.5.2 Transfert de l'état d'application
Le transfert d'état est maintenant facile à comprendre : l'état de « session » n'est pas stocké sur le serveur en tant qu'état de ressource, mais est suivi par le client en tant qu'état d'application. L'état d'application du client change sous la conduite de l'hypermédia fourni par le serveur. Le serveur utilise l'hypermédia pour indiquer au client quels états suivants peuvent être atteints depuis l'état actuel.
Des liens comme « Page suivante » remplissent cette fonction de progression d'état — en vous guidant sur la façon de passer de l'état actuel à l'état suivant possible.
3. Résumé
Actuellement, des projets tels que la version Guangdong XXX et XXX utilisent des services Web RPC et SOAP traditionnels, tandis que le backend du projet Mobile Southern Base XXXX, bien qu'utilisant le format JSON pour les interactions, reste de style RPC. Cet article tente de comprendre rapidement les concepts qui sous-tendent l'architecture RESTful du point de vue de la définition des ressources, de la récupération, de la représentation, de l'association et de la transition d'état. L'architecture RESTful est très différente des approches traditionnelles RPC, SOAP et autres sur le plan philosophique. J'espère que cet article pourra vous aider à comprendre REST.