Flux de travail d'agent LangChain
Dans la section précédente, nous avons découvert les paramètres decreate_agent().
Cette section explore en profondeur les rouages internes de l'Agent pour comprendre comment il fonctionne—comment le modèle et les outils collaborent, et quand l'Agent s'arrête.
Boucle d'exécution de l'Agent
Le cœur d'un Agent est une boucle simple :Appeler le modèle → Vérifier si un outil est nécessaire → Exécuter l'outil → Répéter. Jusqu'à ce que le modèle ne demande plus d'appels d'outils, l'Agent s'arrête et renvoie le résultat final.
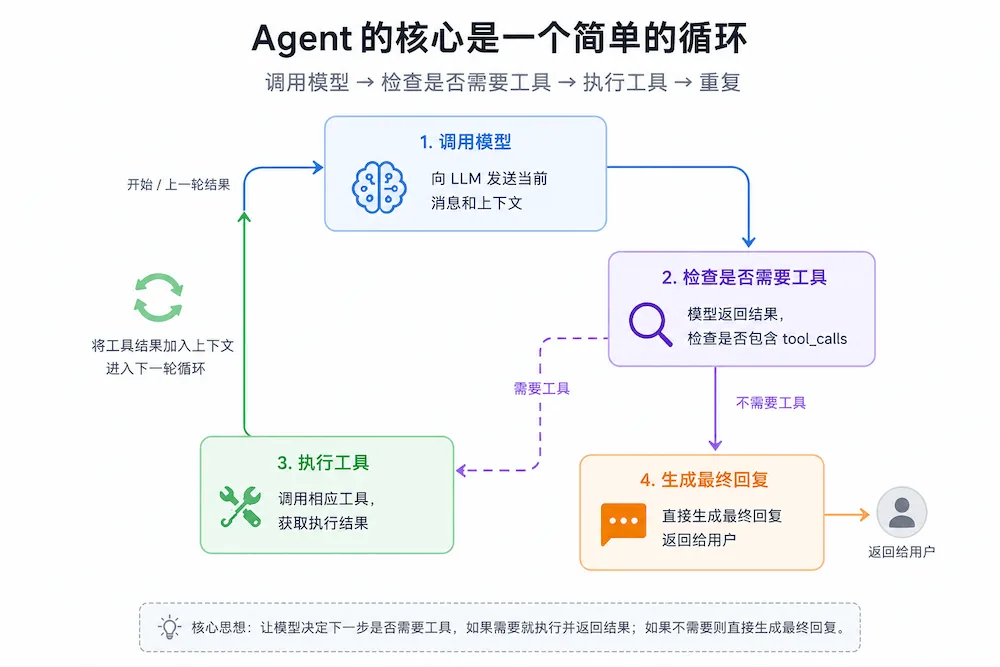
Ci-dessous, nous retraçons chaque étape de l'Agent pour comprendre ce processus.
Exemple
load_dotenv()
from langchain.tools import tool
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage
@tool
def get_weather(city: str) -> str:
"""Interroger la météo pour une ville spécifiée.
Arguments :
city: Nom de la ville
"""
weather_data = {
"Hangzhou": "Ensoleillé, 25°C",
"Beijing": "Nuageux, 18°C",
}
return weather_data.get(city, f"Données météo pour {city} introuvables")
@tool
def get_time(city: str) -> str:
"""Interroger l'heure actuelle pour une ville spécifiée.
Arguments :
city: Nom de la ville
"""
time_data = {
"Hangzhou": "14:30",
"Beijing": "14:30",
"New York": "02:30",
}
return time_data.get(city, f"Données temporelles pour {city} introuvables")
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)
agent = create_agent(
model=model,
tools=[get_weather, get_time],
system_prompt="Vous êtes un assistant utile.",
)
# L'utilisation de stream_mode="updates" vous permet de voir chaque étape
print("=== Trace d'exécution de l'agent ==="\n")
Pas = 0
for chunk in agent.stream(
{"messages": [HumanMessage(content="Quel temps fait-il à Hangzhou maintenant ? Quelle heure est-il ?")]},
stream_mode="updates",
):
step += 1
print(f"--- Étape {step} ---")
for node_name, update in chunk.items():
print(f"Nœud: {node_name}")
if "messages" in update:
for msg in update["messages"]:
if hasattr(msg, 'tool_calls') and msg.tool_calls:
# Le message IA contient des appels d'outils
for tc in msg.tool_calls:
print(f" → Demande d'appel d'outil : {tc['name']}({tc['args']})")
elif msg.type == "tool":
print(f" → Résultat de l'outil [{msg.name}] : {msg.content}")
elif msg.type == "ai" and msg.content:
print(f" → Réponse de l'IA : {msg.content[:100]}")
Résultat de l'exécution:
=== Agent 执行过程追踪 ===

--- 步骤 1 ---
Node: model
  → 请求调用工具: get_weather({'city': '杭州'})
  → 请求调用工具: get_time({'city': '杭州'})

--- 步骤 2 ---
Node: tools
  → 工具结果 [get_weather]: 晴,25°C
  → 工具结果 [get_time]: 14:30

--- 步骤 3 ---
Node: model
  → AI 回复: 杭州现在天气晴朗,气温25°C,当前时间是14:30。
À partir de cette trace, vous pouvez voir que l'Agent a exécuté3 étapes:
- Étape 1 (nœud modèle): Le modèle reçoit la question, détermine qu'il doit appeler les deux outils get_weather et get_time, et renvoie deux tool_calls
- Étape 2 (nœud outils): Exécute les deux outils pour obtenir les résultats de la météo et de l'heure
- Étape 3 (nœud modèle): Le modèle reçoit les résultats de l'outil, détermine que les informations sont suffisantes et génère la réponse finale
Explication détaillée de stream_mode
stream() prend en charge plusieurs stream_modes, chacun fournissant des informations à un niveau de granularité différent :
| Mode | Contenu renvoyé | Scénarios applicables |
|---|---|---|
| updates | Mises à jour de l'état après l'exécution de chaque nœud | Suivre les étapes d'exécution de l'Agent, afficher les résultats intermédiaires |
| values | État complet après l'exécution de chaque nœud | Besoin de voir l'historique complet des messages à chaque étape |
| messages | Flux de messages token par token | Affichage en streaming côté frontend de l'effet de frappe de l'IA |
| custom | Événements personnalisés | Middleware envoie des événements personnalisés via stream_writer |
stream_mode="values" — Afficher les modifications complètes de l'état
Exemple
for i, chunk in enumerate(agent.stream(
{"messages": [HumanMessage(content="Quel temps fait-il à Hangzhou ?")]},
stream_mode="values",
)):
messages = chunk.get("messages", [])
print(f"État {i}: {len(messages)} messages")
for msg in messages:
print(f" [{msg.type}] {str(msg.content)[:80]}")
if i >= 3: # Ne regarder que les premiers états
break
Résultat de l'exécution:
=== stream_mode='values' ===

State 0: 1 条消息
  [human] 杭州天气怎么样?

State 1: 2 条消息
  [human] 杭州天气怎么样?
  [ai]

State 2: 3 条消息
  [human] 杭州天气怎么样?
  [ai]
  [tool] 晴,25°C

State 3: 4 条消息
  [human] 杭州天气怎么样?
  [ai]
  [tool] 晴,25°C
  [ai] 杭州今天天气晴朗,气温25°C,适合出门活动。
stream_mode="messages" — Sortie en streaming jeton par jeton
Exemple
for msg_chunk, metadata in agent.stream(
{"messages": [HumanMessage(content="Présentez Python en une phrase")]},
stream_mode="messages",
):
# msg_chunk est un AIMessageChunk, chacun ne contenant qu'un seul Token
if hasattr(msg_chunk, 'content') and msg_chunk.content:
print(msg_chunk.content, end="", flush=True)
print()
Conditions de sortie de l'Agent
Quand l'Agent s'arrête-t-il ? Principalement dans les cas suivants :
| Condition de sortie | Description | Exemple |
|---|---|---|
| Aucun appel d'outils | tool_calls est vide dans l'AIMessage renvoyé par le modèle | Le modèle considère la tâche terminée et répond directement |
| return_direct=True | Outil marqué pour retourner directement, se termine immédiatement après l'exécution | Outil de type requête, le résultat est la réponse finale |
| structured_response | Le modèle a produit une sortie structurée | La sortie structurée spécifiée par response_format est complète |
| jump_to="end" | Le middleware se termine activement via le contrôle d'état | Violation de permission détectée, arrêt anticipé |
Exemple
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage
# Cas 1 : Le modèle répond directement (aucun outil nécessaire)
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)
agent = create_agent(
model=model,
tools=[], # Pas d'outils
)
result = agent.invoke({
"messages": [HumanMessage(content="Présentez Python en une phrase")]
})
# Le modèle répond directement, la boucle ne s'exécute qu'une seule fois
print(f"Scénario sans outil, nombre de messages : {len(result['messages'])}")
print(f"Réponse : {result['messages'][-1].content[:80]}...")
# Cas 2 : appel d'outil requis (boucle à plusieurs tours)
@tool
def search_course(keyword: str) -> str:
"""Rechercher des cours Example"""
return f"3 cours trouvés en lien avec {keyword}"
agent_with_tools = create_agent(
model=model,
tools=[search_course],
)
result = agent_with_tools.invoke({
"messages": [HumanMessage(content="Rechercher des cours Python")]
})
print(f"\nScénario d'outil, nombre de messages : {len(result['messages'])}")
# Généralement, il y aura : human, ai(tool_call), tool(result), ai(final)
for msg in result["messages"]:
print(f" [{msg.type}]", end="")
if hasattr(msg, 'tool_calls') and msg.tool_calls:
print(f" tool_calls: {[tc['name'] for tc in msg.tool_calls]}")
else:
print(f" {str(msg.content)[:50]}")
Résultat de l'exécution:
无工具场景,消息数: 2
Reply: Example is a programming learning platform for beginners, offering rich tutorials and examples...

有工具场景,消息数: 4
  [human] 搜索 Python 课程
  [ai] tool_calls: ['search_course']
  [tool] 找到 python 相关课程 3 门
  [ai] Searching Example for "Python courses" found 3 related courses...
Comparaison entre invoke et stream
| Méthode | Moment du retour | Scénarios applicables | Expérience utilisateur |
|---|---|---|---|
| invoke() | Renvoie tout en une seule fois après l'achèvement | Scripts, interfaces API, traitement par lots | Voir le résultat complet après avoir attendu |
| stream() | Renvoie les états intermédiaires étape par étape | Interfaces de chat, lorsque le processus doit être affiché | Voir la progression en temps réel |
| ainvoke() | Renvoie après l'achèvement asynchrone | Services web, frameworks asynchrones | Ne bloque pas la boucle d'événements |
| astream() | Retour asynchrone étape par étape | Push WebSocket, SSE | Push en temps réel côté serveur |
Passage de l'ID de thread dans with_config
Si vous utilisez un checkpointer (détaillé dans les chapitres suivants), vous devez passer thread_id via config pour gérer les threads de conversation :
Exemple
# thread_id sert à distinguer les différents threads de conversation
config = {"configurable": {"thread_id": "conversation-001"}}
# méthode invoke
result = agent.invoke(
{"messages": [HumanMessage(content="Hello")]},
config=config,
)
# la méthode stream prend également en charge config
for chunk in agent.stream(
{"messages": [HumanMessage(content="Hello")]},
config=config,
stream_mode="updates",
):
print(chunk)