Pandas Estructuras de datos - DataFrame
DataFrame es otra estructura de datos central en Pandas, similar a una tabla bidimensional o una tabla de datos en una base de datos.
DataFrame es una estructura de datos tabular que contiene un conjunto ordenado de columnas; cada columna puede ser de un tipo de valor diferente (numérico, cadena, booleano).
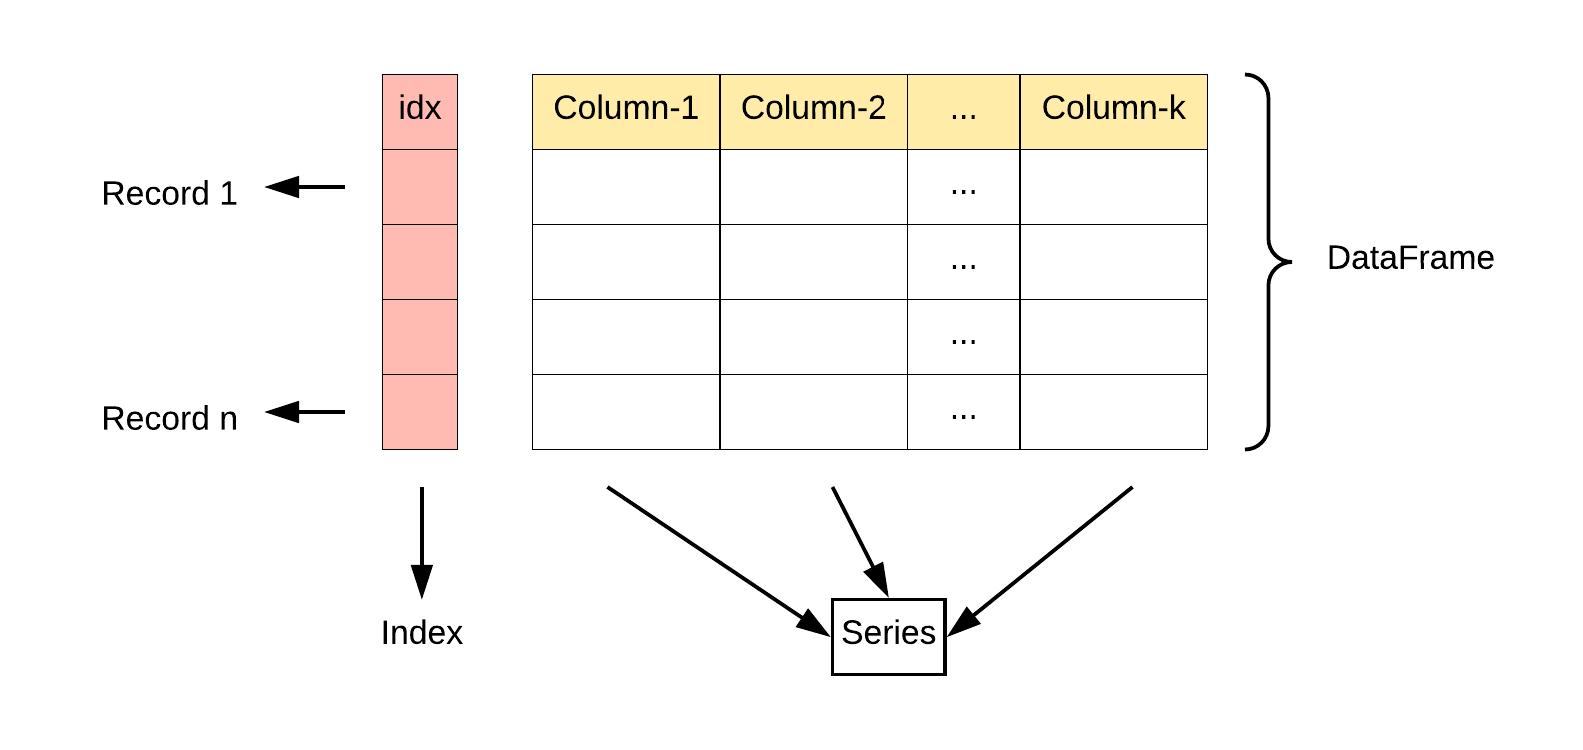
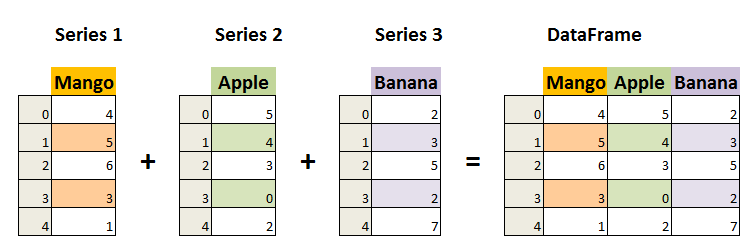
DataFrame tiene tanto índice de filas como índice de columnas; puede considerarse como un diccionario compuesto por Series (que comparten un mismo índice).
DataFrame proporciona varias funciones para realizar operaciones como acceso a datos, filtrado, división, combinación, remodelación, agregación y transformación.
DataFrame es una estructura de datos muy flexible y potente, ampliamente utilizada en tareas como análisis de datos, limpieza, transformación, visualización, etc.
Características de DataFrame:
Estructura bidimensional:
DataFrameEs una tabla bidimensional, que puede considerarse como una hoja de cálculo de Excel o una tabla SQL, con filas y columnas. Puede verse como múltiplesSeriesobjetos que forman un diccionario.Tipos de datos de las columnas:Diferentes columnas pueden contener diferentes tipos de datos, por ejemplo, enteros, flotantes, cadenas u objetos de Python, etc.
-
Índices:
DataFramePuede tener índices de filas y de columnas, similar a los números de fila y etiquetas de columna en Excel. -
Tamaño variable: se pueden agregar y eliminar columnas, similar a un diccionario en Python.
-
Alineación automática: al realizar operaciones aritméticas o de alineación de datos,
DataFramelos índices se alinean automáticamente. -
Manejo de datos faltantes:
DataFramePuede contener datos faltantes; Pandas usaNaN(Not a Number) para representarlos. -
Operaciones con datos: admite operaciones como segmentación de datos, indexación, división en subconjuntos, etc.
-
Soporte de series temporales:
DataFrameTiene soporte especial para datos de series temporales, lo que permite realizar fácilmente segmentación, indexación y operaciones con datos de tiempo. -
Amplias funciones de acceso a datos: mediante
.loc、.ilocy.query()métodos, se puede acceder y filtrar datos de forma flexible. -
Funciones flexibles de procesamiento de datos: incluyen combinación de datos, remodelación, tabla dinámica, agrupación y agregación, etc.
-
Visualización de datos: aunque
DataFrameen sí no es una herramienta de visualización, puede combinarse con bibliotecas de visualización como Matplotlib o Seaborn para visualizar datos. -
Entrada y salida de datos eficiente: permite leer y escribir datos fácilmente, y admite múltiples formatos, como CSV, Excel, bases de datos SQL y HDF5.
-
Estadísticas descriptivas: proporciona una serie de métodos para calcular estadísticas descriptivas, como
.describe()、.mean()、.sum()etc. -
Alineación e integración flexibles de datos: puede, fácilmente, con otros
DataFrameoSeriesobjetos, realizar operaciones de combinación, conexión o actualización. -
Funciones de transformación: pueden transformar los valores en el conjunto de datos, por ejemplo usando
.apply()métodos para aplicar funciones personalizadas. -
Ventana móvil y análisis de series temporales: admite estadísticas de ventana móvil y análisis de series temporales en conjuntos de datos.
El método constructor de DataFrame es el siguiente:
pandas.DataFrame(data=None, index=None, columns=None, dtype=None, copy=False)
Descripción de parámetros:
data: la parte de datos de DataFrame, puede ser un diccionario, una matriz bidimensional, Series, DataFrame u otros objetos que puedan convertirse en DataFrame. Si no se proporciona este parámetro, se crea un DataFrame vacío.index: el índice de filas de DataFrame, utilizado para identificar cada fila de datos. Puede ser una lista, una matriz, un objeto de índice, etc. Si no se proporciona este parámetro, se crea un índice entero predeterminado.columns: el índice de columnas de DataFrame, utilizado para identificar cada columna de datos. Puede ser una lista, una matriz, un objeto de índice, etc. Si no se proporciona este parámetro, se crea un índice entero predeterminado.dtype: especifica el tipo de datos de DataFrame. Puede ser un tipo de datos de NumPy, por ejemplonp.int64、np.float64etc. Si no se proporciona este parámetro, el tipo de datos se infiere automáticamente según los datos.copy: si copiar los datos. El valor predeterminado es False, lo que significa que no copia los datos. Si se establece en True, copia los datos de entrada.
Pandas DataFrame es una estructura de matriz bidimensional, similar a una matriz bidimensional.
Ejemplo - Crear usando listas
data = [['Google', 10], ['Ejemplo', 12], ['Wiki', 13]]
# Crear DataFrame
df = pd.DataFrame(data, columns=['Site', 'Age'])
# Usar el método astype para establecer el tipo de datos de cada columna
df['Site'] = df['Site'].astype(str)
df['Age'] = df['Age'].astype(float)
print(df)
También se puede crear usando un diccionario:
Ejemplo - Crear usando diccionarios
data = {'Site':['Google', 'Ejemplo', 'Wiki'], 'Age':[10, 12, 13]}
df = pd.DataFrame(data)
print (df)
El resultado de salida es el siguiente:
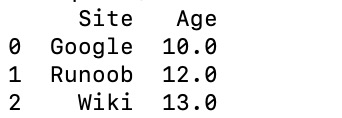
El siguiente ejemplo usa ndarrays para crear; la longitud de los ndarray debe ser la misma. Si se pasa el índice, la longitud del índice debe ser igual a la longitud del array. Si no se pasa índice, por defecto, el índice será range(n), donde n es la longitud del array.
ndarrays se puede consultar en:Objeto NumPy Ndarray
Ejemplo - Crear usando ndarrays
import pandas as pd
# Crear un ndarray bidimensional que contenga sitios web y edades
ndarray_data = np.array([
['Google', 10],
['Ejemplo', 12],
['Wiki', 13]
])
# Usar el constructor de DataFrame para crear el marco de datos
df = pd.DataFrame(ndarray_data, columns=['Site', 'Age'])
# Imprimir el marco de datos
print(df)
El resultado de salida es el siguiente:
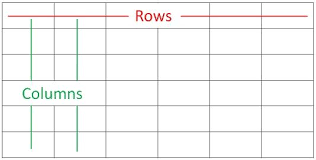
De los resultados anteriores se puede saber que el tipo de datos DataFrame es una tabla que contiene filas (rows) y columnas (columns):
También se puede usar un diccionario (clave/valor), donde la clave del diccionario es el nombre de la columna:
Ejemplo - Crear usando diccionarios
data = [{'a': 1, 'b': 2},{'a': 5, 'b': 10, 'c': 20}]
df = pd.DataFrame(data)
print (df)
El resultado de salida es:
   a   b     c
0  1   2   NaN
1  5  10  20.0
Los datos sin correspondencia sonNaN。
Pandas puede usarlocatributo para devolver los datos de una fila específica. Si no se establece un índice, el índice de la primera fila es0, el índice de la segunda fila es1, y así sucesivamente:
Ejemplo
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
# Cargar los datos en un objeto DataFrame
df = pd.DataFrame(data)
# Devolver la primera fila
print(df.loc[0])
# Devolver la segunda fila
print(df.loc[1])
El resultado de salida es el siguiente:
calories    420
duration     50
Name: 0, dtype: int64
calories    380
duration     40
Name: 1, dtype: int64
Nota:El resultado devuelto es en realidad un dato de Pandas Series.
También se pueden devolver múltiples filas de datos, usando[[ ... ]]formato,...son los índices de cada fila, separados por comas:
Ejemplo
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
# Cargar los datos en un objeto DataFrame
df = pd.DataFrame(data)
# Devolver la primera y segunda fila
print(df.loc[[0, 1]])
El resultado de salida es:
   calories  duration
0       420        50
1       380        40
Nota:El resultado devuelto es en realidad un dato de Pandas DataFrame.
Podemos especificar el valor del índice, como en el siguiente ejemplo:
Ejemplo
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
print(df)
El resultado de salida es:
      calories  duration
day1       420        50
day2       380        40
day3       390        45
Pandas puede usarlocatributo para devolver la fila correspondiente a un índice específico:
Ejemplo
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
# Especificar el índice
print(df.loc["day2"])
El resultado de salida es:
calories    380
duration     40
Name: day2, dtype: int64
Métodos de DataFrame
Las operaciones y métodos comunes de DataFrame se muestran en la siguiente tabla:
| Nombre del método | Descripción de la función |
|---|---|
head(n) | Devuelve las primeras n filas del DataFrame (por defecto las primeras 5 filas) |
tail(n) | Devuelve las últimas n filas del DataFrame (por defecto las últimas 5 filas) |
info() | Muestra información resumida del DataFrame, incluyendo nombres de columnas, tipos de datos, cantidad de valores no nulos, etc. |
describe() | Devuelve estadísticas de las columnas numéricas del DataFrame, como media, desviación estándar, mínimo, etc. |
shape | Devuelve el número de filas y columnas del DataFrame (filas, columnas) |
columns | Devuelve todos los nombres de columnas del DataFrame |
index | Devuelve el índice de filas del DataFrame |
dtypes | Devuelve el tipo de datos de cada columna |
sort_values(by) | Ordena según la columna especificada |
sort_index() | Ordena por índice de filas |
dropna() | Elimina filas o columnas que contengan valores faltantes (NaN) |
fillna(value) | Rellena los valores faltantes con el valor especificado |
isnull() | Detecta valores faltantes, devuelve un DataFrame de valores booleanos |
notnull() | Detecta valores no faltantes, devuelve un DataFrame de valores booleanos |
loc[] | Selecciona datos por índice de etiqueta |
iloc[] | Selecciona datos por índice de posición |
at[] | Accede a un solo elemento del DataFrame (másloc[]eficiente) |
iat[] | Accede a un solo elemento del DataFrame (másiloc[]eficiente) |
apply(func) | Aplica una función a un DataFrame o Series |
applymap(func) | Aplica una función a cada elemento del DataFrame (solo para DataFrame) |
groupby(by) | Operación de agrupación, se usa para agrupar por una columna y realizar estadísticas resumidas |
pivot_table() | Crea una tabla dinámica (pivot table) |
merge() | Combina múltiples DataFrames (similar a la operación JOIN de SQL) |
concat() | Concatena múltiples DataFrames por filas o por columnas |
to_csv() | Exporta el DataFrame a un archivo CSV |
to_excel() | Exporta el DataFrame a un archivo Excel |
to_json() | Exporta el DataFrame a formato JSON |
to_sql() | Exporta el DataFrame a una base de datos SQL |
query() | Consulta el DataFrame usando sintaxis de estilo SQL |
duplicated() | Devuelve un DataFrame booleano que indica si cada fila está duplicada |
drop_duplicates() | Elimina las filas duplicadas |
set_index() | Establece el índice del DataFrame |
reset_index() | Restablece el índice del DataFrame |
transpose() | Transpone el DataFrame (intercambia filas y columnas) |
Ejemplo
# Crear DataFrame
data = {
'Name': ['Alice', 'Bob', 'Charlie', 'David'],
'Age': [25, 30, 35, 40],
'City': ['New York', 'Los Angeles', 'Chicago', 'Houston']
}
df = pd.DataFrame(data)
# Ver las primeras dos filas de datos
print(df.head(2))
# Ver la información básica del DataFrame
print(df.info())
# Obtener estadísticas descriptivas
print(df.describe())
# Ordenar por edad
df_sorted = df.sort_values(by='Age', ascending=False)
print(df_sorted)
# Seleccionar columnas especificadas
print(df[['Name', 'Age']])
# Seleccionar filas por índice
print(df.iloc[1:3]) # Seleccionar las filas segunda a tercera (por posición)
# Seleccionar filas por etiqueta
print(df.loc[1:2]) # Seleccionar las filas segunda a tercera (por etiqueta)
# Calcular estadísticas de grupo (agrupar por ciudad, calcular edad media)
print(df.groupby('City')['Age'].mean())
# Manejar valores faltantes (rellenar valores faltantes)
df['Age'] = df['Age'].fillna(30)
# Exportar a archivo CSV
df.to_csv('output.csv', index=False)
El resultado de salida es:
# 查看前两行数据
     Name  Age         City
0   Alice   25     New York
1     Bob   30  Los Angeles

# 查看 DataFrame 的基本信息
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 4 entries, 0 to 3
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   Name    4 non-null      object
 1   Age     4 non-null      int64
 2   City    4 non-null      object
dtypes: int64(1), object(2)
memory usage: 148.0+ bytes

# 获取描述统计信息
             Age
count   4.000000
mean   32.500000
std     6.454972
min    25.000000
25%    27.500000
50%    32.500000
75%    37.500000
max    40.000000

# 按年龄排序
      Name  Age         City
3    David   40     Houston
2  Charlie   35      Chicago
1      Bob   30  Los Angeles
0    Alice   25     New York

# 按标签选择行
      Name  Age         City
1     Bob   30  Los Angeles
2  Charlie   35      Chicago

# 计算分组统计(按城市分组,计算平均年龄)
City
Chicago        35.0
Houston        40.0
Los Angeles    30.0
New York       25.0
Name: Age, dtype: float64
Más información sobre DataFrame
Crear DataFrame
Crear a partir de un diccionario:Las claves del diccionario se convierten en nombres de columnas y los valores en datos de columnas.
Ejemplo
# Crear DataFrame a través de un diccionario
df = pd.DataFrame({'Column1': [1, 2, 3], 'Column2': [4, 5, 6]})
Crear a partir de una lista de listas:La lista externa representa las filas y las listas internas representan las columnas.
# Crear DataFrame a través de una lista de listasEjemplo
columns=['Column1', 'Column2', 'Column3'])
Crear a partir de un array de NumPy:Proporcionar un array de NumPy bidimensional.
Ejemplo
# Crear DataFrame a través de un array de NumPy
df = pd.DataFrame(np.array([[1, 2, 3], [4, 5, 6], [7, 8, 9]]))
Crear DataFrame a partir de Series:Mediantepd.Series()crear.
Ejemplo
s1 = pd.Series(['Alice', 'Bob', 'Charlie'])
s2 = pd.Series([25, 30, 35])
s3 = pd.Series(['New York', 'Los Angeles', 'Chicago'])
df = pd.DataFrame({'Name': s1, 'Age': s2, 'City': s3})
Atributos y métodos de DataFrame
El objeto DataFrame tiene muchos atributos y métodos para manipulación, indexación y procesamiento de datos, por ejemplo: shape, columns, index, head(), tail(), info(), describe(), mean(), sum(), etc.
Ejemplo
print(df.shape) # Forma (shape)
print(df.columns) # Nombres de columnas
print(df.index) # Índice
print(df.head()) # Primeras filas de datos, por defecto las primeras 5 filas
print(df.tail()) # Últimas filas de datos, por defecto las últimas 5 filas
print(df.info()) # Información de datos
print(df.describe())# Estadísticas descriptivas
print(df.mean()) # Calcular la media
print(df.sum()) # Calcular la suma
Acceder a los elementos de DataFrame
Acceder a columnas:Utilice el nombre de la columna como atributo o mediante.loc[]、.iloc[]acceder, también puede usar índice por etiqueta o por posición.
Ejemplo
print(df['Column1'])
# Acceder mediante atributo
print(df.Name)
# Acceder mediante .loc[]
print(df.loc[:, 'Column1'])
# Acceder mediante .iloc[]
print(df.iloc[:, 0]) # Supongamos que 'Column1' es la primera columna
# Acceder a un solo elemento
print(df['Name'][0])
Acceder a filas:Use las etiquetas de las filas y.loc[]acceder.
Ejemplo
print(df.loc[0, 'Column1'])
Modificar DataFrame
Modificar datos de una columna:Asignar directamente a la columna.
df['Column1'] = [10, 11, 12]
Agregar una nueva columna:Asignar un valor a la nueva columna.
df['NewColumn'] = [100, 200, 300]
Agregar una nueva fila:Usar los métodos loc, append o concat.
Ejemplo
df.loc[3] = [13, 14, 15, 16]
# Usar append para agregar una nueva fila al final
new_row = {'Column1': 13, 'Column2': 14, 'NewColumn': 16}
df = df.append(new_row, ignore_index=True)
Nota:append()El método ha sido marcado como obsoleto en la versión 1.4.0 de pandas y será eliminado en versiones futuras. Oficialmente se recomienda usarconcat()como método alternativo para realizar operaciones de combinación de datos.
El método concat() se utiliza para combinar dos o más DataFrames. Cuando desees agregar una fila a otro DataFrame, puedes convertir la nueva fila en un nuevo DataFrame y luego usar concat():
Ejemplo
new_row = pd.DataFrame([[4, 7]], columns=['A', 'B']) # Crear un DataFrame que contenga solo la nueva fila
df = pd.concat([df, new_row], ignore_index=True) # Agregar la nueva fila al DataFrame original
print(df)
Eliminar elementos de DataFrame
Eliminar columnas:Usar el método drop.
df_dropped = df.drop('Column1', axis=1)
Eliminar filas:De la misma manera, usar el método drop.
df_dropped = df.drop(0) # 删除索引为 0 的行
Análisis estadístico de DataFrame
Estadística descriptiva:Usar.describe()para ver el resumen estadístico de las columnas numéricas.
df.describe()
Calcular estadísticas:Usar funciones de agregación como.sum()、.mean()、.max()etc.
df['Column1'].sum()
df.mean()
Operaciones de indexación de DataFrame
Restablecer el índice:Usar.reset_index()。
df_reset = df.reset_index(drop=True)
Establecer el índice:Usar.set_index()。
df_set = df.set_index('Column1')
Indexación booleana de DataFrame
Usar expresiones booleanas: filtrar el DataFrame según una condición.
df[df['Column1'] > 2]
Tipos de datos de DataFrame
Ver los tipos de datos: usardtypesatributo.
df.dtypes
Convertir tipos de datos:Usarastypemétodo.
df['Column1'] = df['Column1'].astype('float64')
Combinación y división de DataFrame
Combinar:Usarconcatomergemétodo.
# 纵向合并
pd.concat([df1, df2], ignore_index=True)

# 横向合并
pd.merge(df1, df2, on='Column1')
Dividir:Usarpivot、melto una función personalizada.
# 长格式转宽格式
df_pivot = df.pivot(index='Column1', columns='Column2', values='Column3')

# 宽格式转长格式
df_melt = df.melt(id_vars='Column1', value_vars=['Column2', 'Column3'])
Indexación y segmentación
DataFrame admite operaciones de indexación y segmentación sobre filas y columnas.
Ejemplo
print(df[['Name', 'Age']]) # Extraer varias columnas
print(df[1:3]) # Segmentar filas
print(df.loc[:, 'Name']) # Extraer una sola columna
print(df.loc[1:2, ['Name', 'Age']]) # Extraer filas y columnas específicas mediante índice por etiqueta
print(df.iloc[:, 1:]) # Extraer columnas específicas mediante índice por posición
Notas
DataFrameEs una estructura de datos flexible que puede contener columnas de diferentes tipos de datos.- Los nombres de columnas y los índices de filas pueden ser cadenas, enteros, etc.
DataFrameLa selección, el filtrado, la modificación y el análisis de datos se pueden realizar de diversas formas.- Mediante
DataFramelas operaciones sobre DataFrame, se pueden realizar tareas de limpieza, transformación, análisis y visualización de datos.